Das deutsche Modell Kolibri-1 von Aleph Alpha gegen gpt-oss-120b und Qwen3.5, von der Speicherbandbreite über den Durchsatz bis zur Klassifizierungsqualität
Zwei neue KI-Server standen da, je ein Dell mit NVIDIA GB10, das ist die Grace-Blackwell-Klasse wie im DGX Spark. 128 GB Unified Memory, auf dem Papier eine Ansage. In der Praxis zäh. Daraus wurde ein kleiner, aber ehrlicher Benchmark: drei Mixture-of-Experts-Modelle auf derselben Hardware, gemessen in Durchsatz, Latenz, Parallelität, Speicher und, das ist der interessante Teil, in der Qualität auf einer echten Klassifizierungsaufgabe. Einmal quer durch, mit offenen Zahlen und offenen Grenzen.
Die Testumgebung
Damit die Zahlen einzuordnen sind, zuerst die Hardware. Zwei baugleiche Server, jeweils:
- NVIDIA GB10 (Grace Blackwell), Compute Capability 12.1, also die GPU-Architektur sm_121
- 20 ARM-Kerne (Cortex-X925 und A725), aarch64
- 128 GB Unified Memory, den sich CPU und GPU teilen, davon rund 121 GB nutzbar, Bandbreite rund 273 GB/s
- 4 TB NVMe, Ubuntu 24.04, NVIDIA-Treiber 580, CUDA 13.0, alles in Docker
Im Einsatz sind die Server für n8n-Workflows, die eingehende Datensätze klassifizieren, dazu Webrecherche, Textextraktion und Whisper für Transkription. Der Benchmark läuft also nicht im Labor, sondern auf der Maschine, die den Job danach wirklich macht.
Die Diagnose: der Flaschenhals ist die Bandbreite
Die Ausgangslage mit dichten Modellen war ernüchternd. Ein 27B-Modell in Q4 lief mit 12,6 Token pro Sekunde, ein 30B-Modell in Q8 mit 7,7. Statt an Parametern zu drehen, habe ich den Flaschenhals ausgerechnet. Reverse Engineering am eigenen Server.
Bei einem dichten Modell müssen für jedes einzelne Token alle Gewichte durch den Speicher. Das theoretische Maximum ist damit die Bandbreite geteilt durch die Modellgröße, also 273 GB/s durch 16,7 bzw. 32,3 GB. Das ergibt rund 16 und 8,5 Token pro Sekunde. Beide Server liefen also schon bei 77 bis 91 Prozent ihres physikalischen Limits. An den Reglern zu drehen hätte fast nichts gebracht. Der Engpass ist die Speicherbandbreite, nicht die Rechenleistung.
Der Hebel: Mixture of Experts
Wenn pro Token alle Gewichte gelesen werden müssen, dann sorg dafür, dass es weniger Gewichte pro Token sind. Genau das machen Mixture-of-Experts-Modelle. Sie haben viele Parameter insgesamt, aber pro Token ist nur ein kleiner Teil aktiv.
Server eins bekam Qwen3.5-35B-A3B, von 35 Milliarden Parametern sind nur 3 aktiv. Ergebnis: 65,7 statt 12,6 Token pro Sekunde. Server zwei bekam gpt-oss-120b, 117 Milliarden gesamt, davon 5,1 aktiv, und sprang von 7,7 auf 54,7. Das ist Faktor 5,2 und Faktor 7,1. Gleiche Hardware, gleicher Strom, nur der Modelltyp war anders.
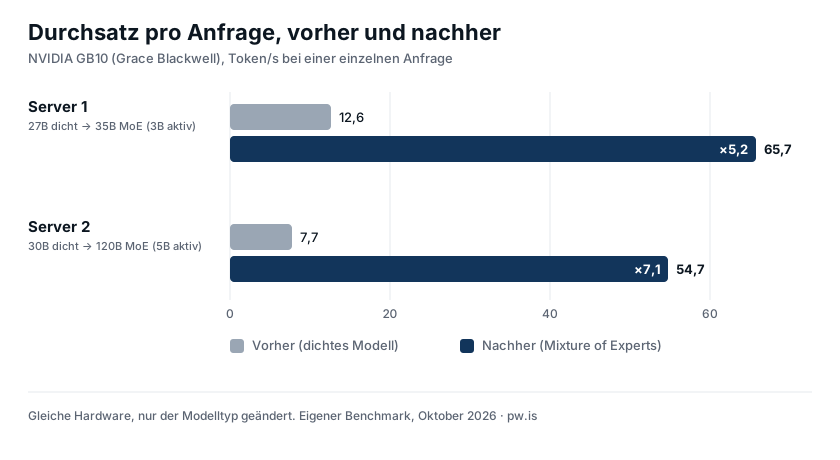
Die ganze Messreihe pro Einzelanfrage, von der Ausgangslage bis zu den verschiedenen Serving-Wegen:
| Konfiguration | Server | Token/s |
|---|---|---|
| Qwen3.5-27B dicht, Q4 (vorher) | 1 | 12,6 |
| Muse-Glimmer-30B dicht, Q8 (vorher) | 2 | 7,7 |
| Qwen3.5-35B-A3B Q4, llama.cpp (offizielles Image) | 1 | 63,1 |
| Qwen3.5-35B-A3B Q4, llama.cpp (Eigenbau sm_121) | 1 | 65,7 |
| gpt-oss-120b MXFP4, llama.cpp (Eigenbau) | 2 | 54,7 |
| Qwen3.5-35B-A3B FP8, vLLM | 1 | 46 bis 50 |
| Kolibri-1 FP8, vLLM 0.29 | 2 | 42 |
Die Software für neue Hardware ist noch roh
Der Weg dahin war nicht geschenkt, und das ist ein Befund für sich. Die GB10 bringt mit sm_121 unter CUDA 13 eine frische Architektur mit, und die Standard-Software hinkt hinterher. Das offizielle llama.cpp-Image mit CUDA 12.8 lieferte für gpt-oss nur Zeichensalat, weil ihm die passenden Kernels fehlen. Erst ein selbst gebautes llama.cpp mit nativen sm_121-Kernels lief sauber, bei Qwen brachte der Eigenbau zusätzlich sieben Prozent. vLLM 0.29 mit CUDA 12.9 hatte eigene Probleme, und das Aleph-Alpha-Image für Kolibri gibt es nur für x86, nicht für ARM. Auf brandneuen Beschleunigern baust du den Stack selbst, sonst misst du Fehler statt Leistung.
Durchsatz unter Last
Eine einzelne Anfrage ist nur die halbe Geschichte. Unter Last zählt der Gesamtdurchsatz. Bei vier bis acht parallelen Anfragen stieg er auf das Zwei- bis Vierfache. Die Grenze ist dabei nicht ein Absturz, sondern der Timeout, weil jede einzelne Anfrage langsamer wird.
Spannend ist der Modellvergleich. Einzeln ist Kolibri-1 das langsamste Modell, aber mit mehr parallelen Anfragen holt es stark auf. Erst der Gesamtdurchsatz zeigt, was ein Modell unter echter Last leistet.
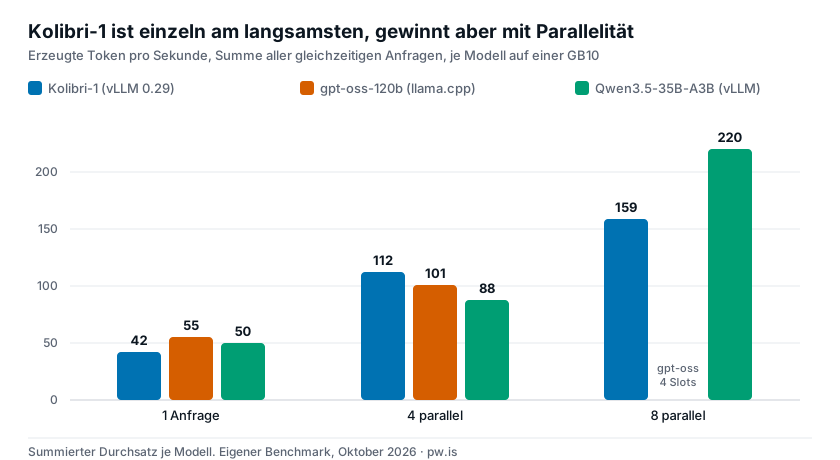
Die vollständige Durchsatztabelle, jeweils als Summe über alle gleichzeitigen Anfragen:
| Modell und Stack | 1 Anfrage | 4 parallel | 8 parallel |
|---|---|---|---|
| Qwen3.5-35B-A3B Q4, llama.cpp | 65,7 | 150 | n/a (4 Slots) |
| gpt-oss-120b, llama.cpp | 54,7 | 101 | n/a (4 Slots) |
| Qwen3.5-35B-A3B FP8, vLLM | 50 | 88 | 220 |
| Kolibri-1, vLLM | 42 | 112 | 159 |
Latenz und Praxislauf
Die Zeit bis zum ersten Token lag bei vLLM-Qwen zwischen 140 und 180 Millisekunden, bei Kolibri zwischen 75 und 155, bei gpt-oss bei rund 100. Interessanter ist der echte Workflow: die Klassifizierung eingehender Datensätze, Prompt rund 3.500 Tokens, strukturierte JSON-Antwort, 74 echte Fälle nacheinander.
| Modell | Sekunden pro Fall | Laufzeit, 74 Fälle |
|---|---|---|
| Qwen3.5-27B dicht (Referenz, vorher) | ca. 81 | 99:53 min |
| Devstral-Small-24B dicht (Referenz) | ca. 58 | 71:16 min |
| gpt-oss-120b (MoE) | ca. 37 | ca. 53 min |
| Qwen3.5-35B-A3B, vLLM (MoE, Reasoning aus) | ca. 14 | 23:47 min |
| Kolibri-1 (MoE, Reasoning „medium“) | ca. 102 | 2:16 h |
Die Laufzeit des produktiven Durchlaufs sank von knapp 100 auf 24 Minuten, Faktor 4,2. Kolibri fällt hier aus dem Rahmen, dazu gleich mehr.
Speicher und Ladezeit
Der große Unified Memory ist der eigentliche Grund, so eine Box zu kaufen. Er fasst auch große MoE-Modelle komplett. gpt-oss-120b belegt 63 GB, Qwen3.5-35B in Q4 nur 22 GB und in FP8 rund 35 GB. Kolibri-1 belegt 73,6 GiB für die Gewichte plus 29,4 GiB für den Cache und hat damit bei einer GPU-Speicher-Auslastung von 0,85 Platz für fast drei Millionen Tokens Kontext.
Die Ladezeiten unterscheiden sich stark. llama.cpp ist in 30 bis 70 Sekunden da, Kolibri über vLLM braucht rund 11 Minuten. Für einen Dauerbetrieb egal, für schnelles Ausprobieren ein echter Faktor.
Die Samples und die Qualität
Token pro Sekunde sind schön, aber am Ende zählt, ob die Antwort stimmt. Deshalb gibt es im Benchmark eine Qualitätsmessung gegen eine manuelle Referenz, und das ist der Teil, der am meisten lehrt.
Die Aufgabe ist eine zweiklassige Klassifizierung aus einem produktiven Workflow, auf Basis strukturierter Angaben zu einem Betrieb. Es gibt eine große Mehrheitsklasse und eine deutlich kleinere, schwer zu treffende Minderheitsklasse. Zwei Datensätze kamen zum Einsatz: ein Durchlauf über 74 echte Fälle für die Laufzeit oben, und ein Abgleich von 200 Betrieben als geschichtete Stichprobe gegen eine von Hand gepflegte Referenzklassifizierung. Jedes Modellergebnis wird Fall für Fall mit der Referenz verglichen.
| Kennzahl (200er Stichprobe) | Kolibri-1 | gpt-oss-120b | Qwen3.5-35B-A3B |
|---|---|---|---|
| Mehrheitsklasse korrekt | 85 % | 47 % | 95 % |
| Minderheitsklasse erkannt (von 70) | 20 | 34 | 23 |
| Zeit pro Fall | 167 s (3 parallel) | 37 s | 12 s |
Das Ergebnis ist unbequem und ehrlich. Kein Modell erkennt die schwierige Minderheitsklasse zuverlässig. In der reinen Gesamttrefferquote schlägt keins die naive Regel, einfach alles der Mehrheitsklasse zuzuordnen. Und mehr Nachdenken hilft hier erstaunlich wenig: Von 40 noch einmal mit vollem Token-Budget nachgerechneten Fällen gehörten 25 zur Minderheitsklasse, Kolibri erkannte davon nur vier und ordnete 15 der falschen Klasse zu. Die Modelle sind gut für die Vorsortierung mit menschlicher Prüfung, nicht für die Entscheidung allein.
Ein praktischer Nebenbefund zum Token-Budget. Mit dem ursprünglichen Limit von 6.000 Tokens brachen Reasoning-Fälle mittendrin ab. Erst bei 16.000 Tokens und 600 Sekunden Timeout lief alles durch, einzelne Kolibri-Fälle brauchten dabei fast das gesamte Budget, bis knapp 16.000 Tokens, nur zum Nachdenken.
Kolibri-1 von Aleph Alpha im Detail
Weil es ein deutsches Modell ist und selten belastbar getestet wird, hier Kolibri-1 von Aleph Alpha genauer. Architektonisch ein MoE mit 78 Milliarden Parametern gesamt und 3,46 Milliarden aktiv, betrieben in FP8 über vLLM 0.29 mit dem Aleph-Alpha-Plugin. Das lief nur mit Workarounds, weil das Hersteller-Image auf x86 zielt und die GB10 ARM ist. Inzwischen läuft Kolibri bei uns im Dauerbetrieb.
Zwei Dinge muss man über Kolibri wissen. Erstens das Sampling. Bei temperature 0 dreht das Reasoning in Endlosschleifen, derselbe Satz wiederholt sich bis zu 56-mal. Die Herstellerempfehlung mit temperature 1.0, top_p 0.97 und top_k 128 bricht das auf, der Reasoning-Aufwand lässt sich über chat_template_kwargs steuern. Zweitens der Durchsatz im richtigen Licht. Pro Token ist Kolibri schnell, einzeln 42 Token pro Sekunde, und es skaliert sauber auf 159 bei acht parallelen Anfragen. Pro Aufgabe ist es trotzdem das langsamste Modell, weil es im Reasoning-Modus über 4.000, im Extremfall fast 16.000 Tokens erzeugt, bevor eine Antwort kommt. Token pro Sekunde ist eine verführerische Kennzahl. Was zählt, ist die Zeit pro Aufgabe.
Methodik
Damit die Zahlen nachvollziehbar sind, die Messung im Detail.
- Synthetischer Durchsatz: ein eigenes Python-Skript gegen die OpenAI-kompatible API. Ein fester Erklär-Prompt mit rund 300 Wörtern Zielantwort, höchstens 400 Tokens, Reasoning aus. Die Token pro Sekunde stammen aus den Server-Timings von llama.cpp beziehungsweise wurden bei vLLM per Streaming ab dem ersten Token gemessen. Einzeln zwei bis drei Wiederholungen, dann vier und acht parallele Anfragen.
- Praxistest: 74 echte Fälle nacheinander über den produktiven n8n-Workflow, mit fünf Sekunden Pause zwischen den Aufrufen, wie beim Referenzlauf im August.
- Qualität: 200 Betriebe als geschichtete Stichprobe, Fall für Fall gegen die manuelle Referenzklassifizierung abgeglichen.
Grenzen und Fallstricke
Ein ehrlicher Benchmark nennt seine Schwächen.
- Varianz zwischen Läufen: Selbst bei
temperature 0fiel bei gpt-oss im zweiten Lauf jede dritte Zuordnung anders aus. Ein einzelner Durchlauf ist kein belastbarer Modellvergleich, und genau diesen Fehler sieht man in vielen Benchmarks. - Messumfang: Einige Durchsatzwerte beruhen auf wenigen Wiederholungen. Der Stromverbrauch wurde nicht sauber protokolliert, im Leerlauf zeigte die GPU rund 9 Watt, unter Last liegen keine belastbaren Zahlen vor.
- Übertragbarkeit: Die Qualitätszahlen gelten für diese eine Aufgabe und diese Stichprobe. Sie sagen etwas über die Eignung zur Vorsortierung, nicht über die allgemeine Güte der Modelle.
Kernaussagen
1. Auf der GB10 ist der Flaschenhals die Speicherbandbreite, nicht die Rechenleistung. Dichte 27- bis 30B-Modelle sind dort die falsche Wahl, MoE-Modelle mit drei bis fünf Milliarden aktiven Parametern sind fünf- bis siebenmal schneller. 2. Der große Unified Memory ist der eigentliche Trumpf. Er fasst auch gpt-oss-120b oder Kolibri-1 mit 78 Milliarden Parametern komplett. 3. Parallelität vervielfacht den Durchsatz, die Grenze ist der Timeout, nicht der Absturz. 4. Die Software für sm_121 ist noch unreif, eigene Builds mit CUDA 13 sind Pflicht. 5. Token pro Sekunde allein führt in die Irre. Reasoning-Modelle wie Kolibri sind pro Token schnell und pro Aufgabe langsam. Und keine Geschwindigkeit ersetzt die Qualitätsprüfung: Für die harte Minderheit braucht es weiter den Menschen in der Schleife.