Eine große Lernplattform für IT-Sicherheit belohnt Fleiß mit Punkten, Serien und einer Bestenliste. Nur prüft niemand, ob am anderen Ende ein Mensch sitzt. Ein kleines Testwerkzeug beantwortet pausenlos Quizfragen, baut nebenbei einen kompletten Lösungsschlüssel auf und treibt die Serie vollautomatisch weiter. Was das über Integrität in spielerischen Systemen verrät, und wie man so einen Fund verantwortungsvoll meldet.
Lernplattformen für IT-Sicherheit arbeiten mit Spielmechanik. Man löst Aufgaben, sammelt Punkte, hält eine tägliche Serie am Laufen und klettert in einer Bestenliste nach oben. Das motiviert, und es soll zeigen, wer dranbleibt. Einen Teil davon machen Quizfragen aus: eine Frage, ein paar Antworten, sofortige Rückmeldung, der nächste Punkt.
Bei einem autorisierten Test der zugehörigen mobilen App ist mir aufgefallen, dass genau diese Mechanik keinerlei Schutz gegen Automatisierung hat. Keine Begrenzung, keine Pause, keine Prüfung, ob die Eingaben von einem Menschen kommen. Was als kurzer Blick begann, wurde über mehrere Wochen ein kleines Experiment, und am Ende stand eine Meldung an das Sicherheitsteam des Herstellers. Keiner der Funde betrifft fremde Konten oder fremde Daten. Es geht allein um die Integrität des Punkte-, Serien- und Bewertungssystems.
Was eine Maschine sieht
Der entscheidende Punkt sitzt nicht im Netzwerk, sondern in der Bedienoberfläche. Moderne Betriebssysteme stellen jede App über eine Schnittstelle für Bedienhilfen bereit, den sogenannten Accessibility-Baum. Das ist eine gute Sache: Vorleseprogramme und andere Hilfstechnik lesen darüber den Bildschirm für Menschen, die ihn nicht sehen oder nicht bedienen können. Diese Schnittstelle darf also nicht verschwinden.
Sie legt aber die ganze App in maschinenlesbarer Form offen. Im Test war über den Bedienhilfen-Baum alles sichtbar, was eine Quizfrage ausmacht: der vollständige Fragetext, alle Antwortmöglichkeiten mit ihrer Position auf dem Schirm und, nach dem Antippen, die Rückmeldung richtig oder falsch. Mit Standard-Testwerkzeugen, wie man sie zur normalen App-Prüfung einsetzt, lässt sich das auslesen und bedienen. Kein Eingriff in die App selbst, kein Auseinandernehmen des Programms, kein verändertes Binary. Es genügt, die App ganz regulär zu bedienen, nur eben programmgesteuert.
Keine Bremse
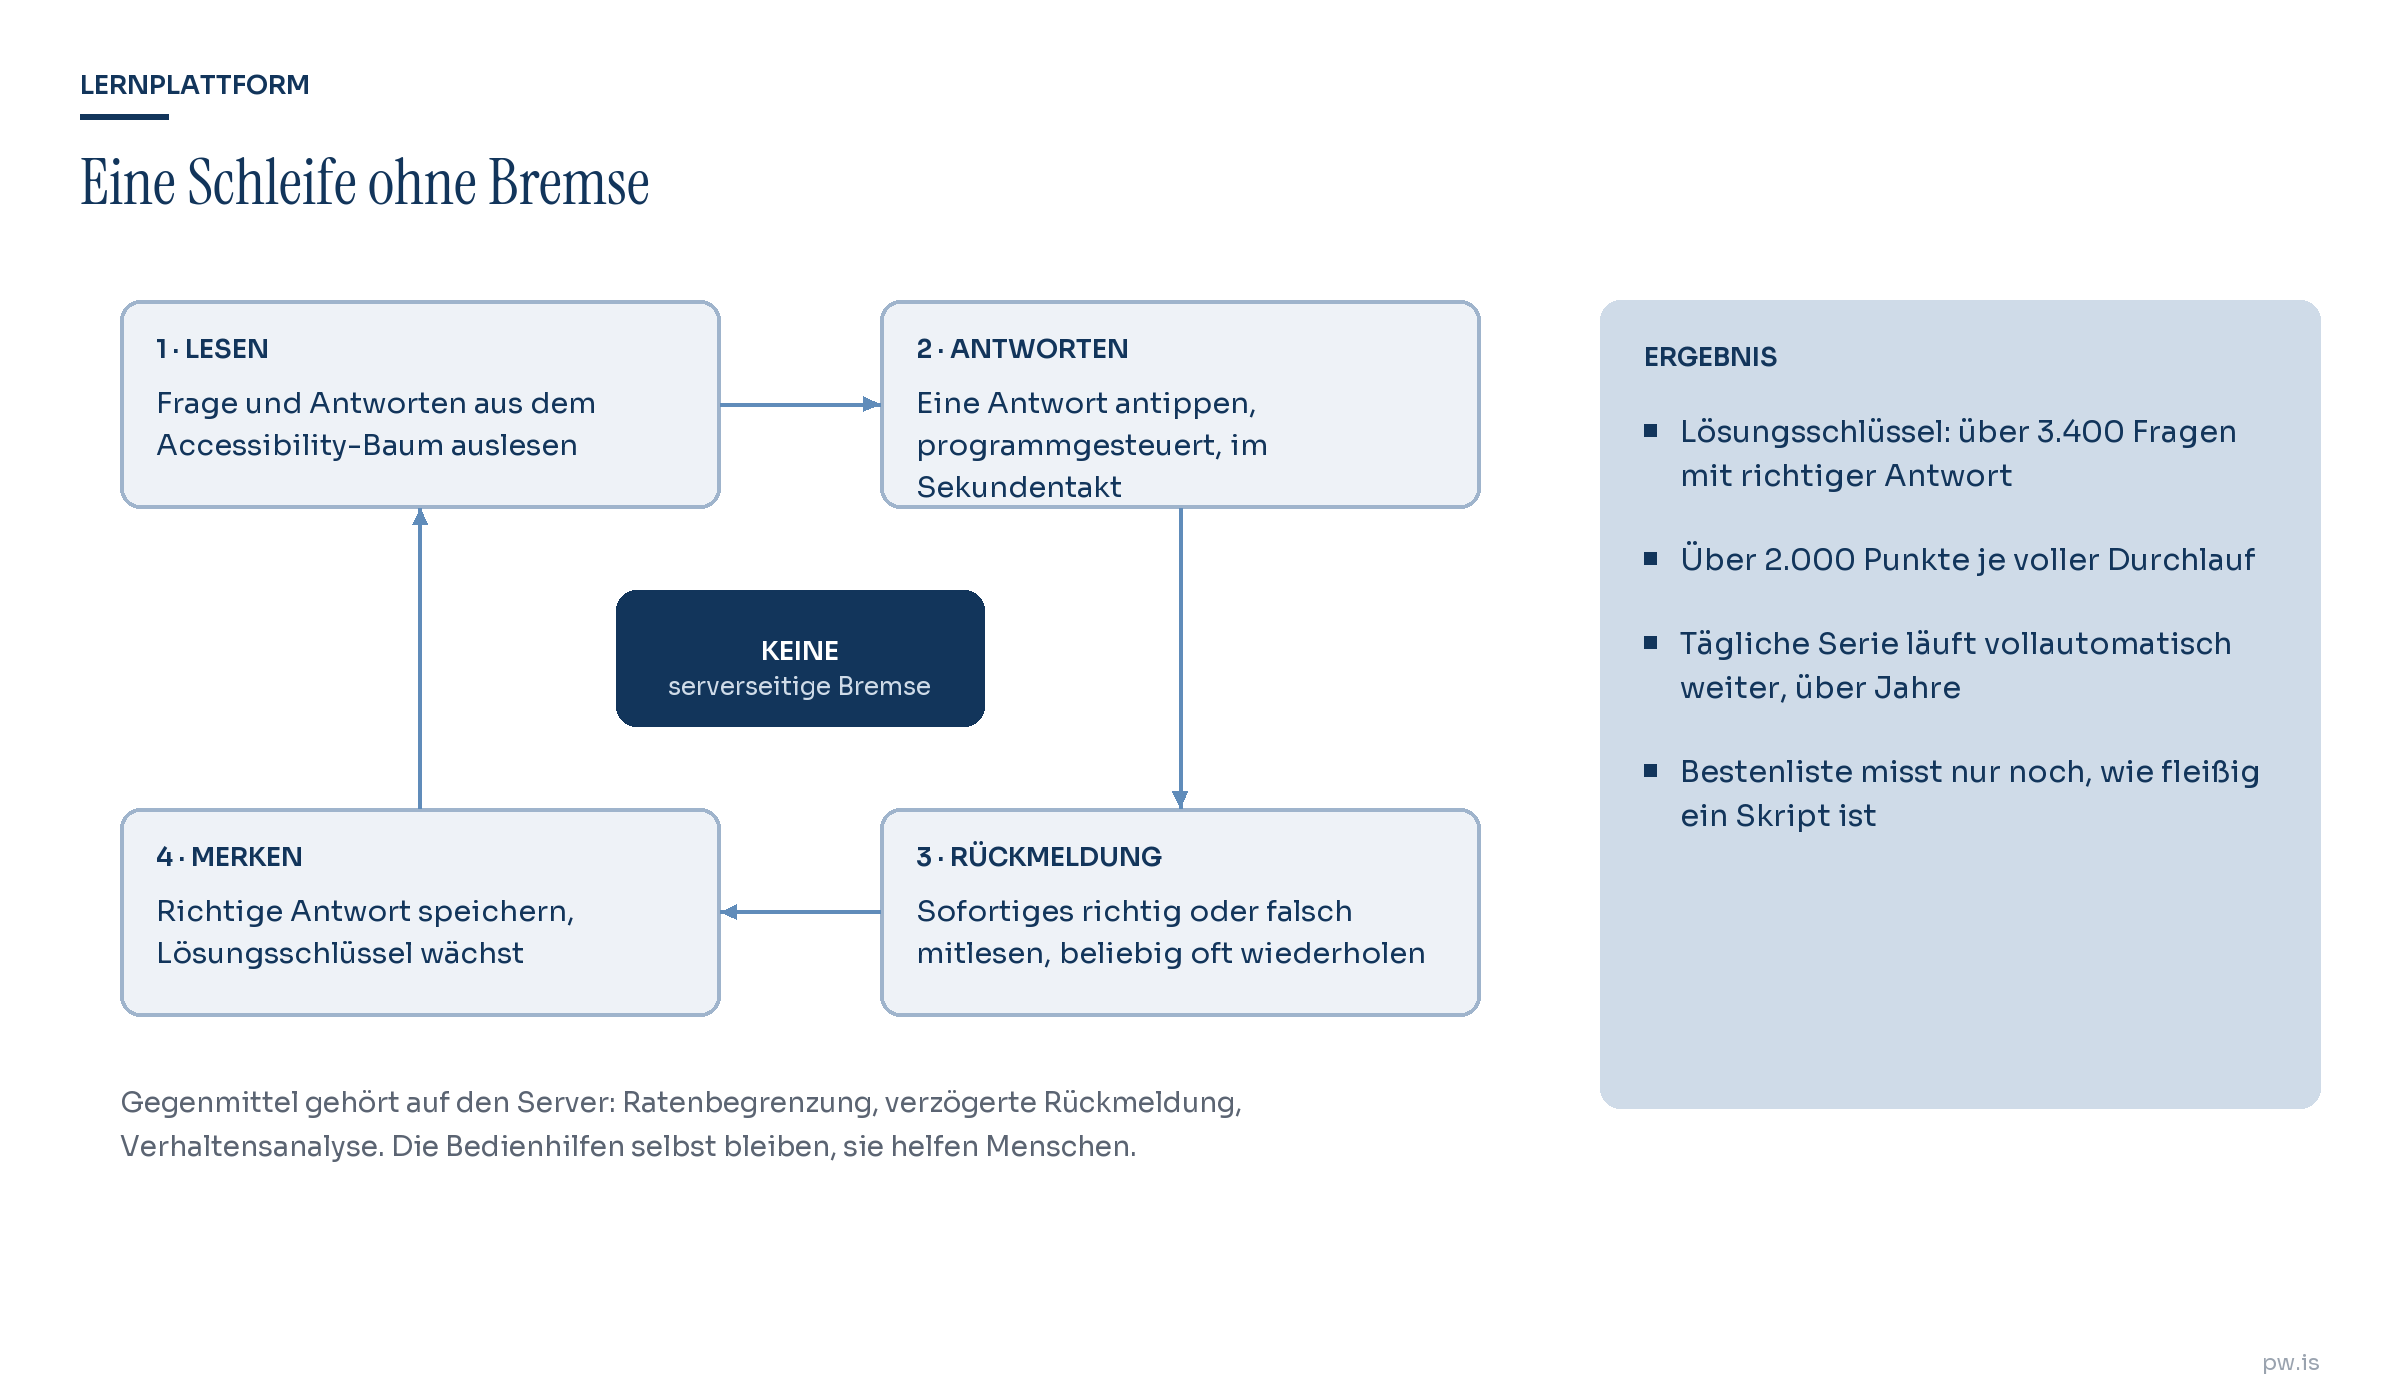
Ab da ist der Rest eine Fleißaufgabe für die Maschine. Das Testwerkzeug liest die Frage, tippt eine Antwort, liest die Rückmeldung, merkt sie sich und geht zur nächsten Frage. Niemand hält es auf.
Die Zahlen aus dem Test machen die fehlende Bremse greifbar. An einem einzigen Tag wurden über alle Lernpfade hinweg mehr als 1.600 Fragen beantwortet. Über 17 aktive Tage summierte sich das auf mehr als 17.000 protokollierte Quiz-Interaktionen. Keine Begrenzung pro Modul, kein Rätselbild, keine Abkühlphase, kein Hinweis, dass hier etwas nicht stimmt. Antippen im Sekundentakt wird genauso angenommen wie die bedächtige Eingabe eines Menschen.
Der Lösungsschlüssel entsteht von selbst
Die eigentliche Pointe ist nicht die Menge, sondern was daraus entsteht. Weil die App nach jeder Antwort sofort verrät, ob sie richtig war, und weil man eine Frage beliebig oft wiederholen darf, baut sich der Lösungsschlüssel von allein auf. Beim ersten Durchlauf rät das Werkzeug, merkt sich die richtige Antwort und kennt sie beim nächsten Mal. Nach wenigen Durchläufen ist für jede Frage die Lösung bekannt.
Im Test wuchs so eine Sammlung von über 2.250 Frage-Antwort-Paaren, und über alle Lernpfade hinweg ließen sich mehr als 3.400 verschiedene Fragen mitsamt richtiger Antwort katalogisieren. Die Antworten stehen nicht offen im ersten Seitenaufbau, das wäre zu plump. Sie fallen aber durch die sofortige Rückmeldung und die unbegrenzten Wiederholungen praktisch von selbst heraus. Ein vollständiger Lösungsschlüssel, einmal zusammengetragen, macht jede Wissensabfrage wertlos.
Warum das zählt
Man könnte sagen: ein Quiz, na und. Der Punkt ist, woran so eine Plattform ihre Aussagen knüpft. Punkte, Serien und die Bestenliste sollen zeigen, wer wirklich übt und etwas kann. Genau diese Aussage hält nicht, wenn eine Maschine dieselben Punkte im Minutentakt einsammelt.
Das Punktesystem vergibt gestaffelt, beim ersten Mal mehr, bei Wiederholung weniger. Das bremst einen Menschen, eine Maschine nicht. Pro vollem Durchlauf über alle Pfade kamen über 2.000 Punkte zusammen. Die tägliche Serie, bei der es darum geht, keinen Tag auszulassen, läuft durch einen einzigen automatisierten Kontakt pro Tag zuverlässig weiter, über Jahre hinweg. Eine Serie, die eigentlich für Beharrlichkeit steht, beweist dann nur noch, dass ein Skript läuft. Bestenliste, Serien-Abzeichen und Kompetenzwerte spiegeln damit nicht mehr verlässlich, was ein Mensch tatsächlich getan oder gelernt hat.
Dazu kommt eine Kleinigkeit, die alles andere verstärkt: Die Sitzung blieb über Tage gültig, ohne erneute Anmeldung, und das Sitzungsmerkmal lag im Klartext auf dem Gerät. Für sich genommen harmlos. In Kombination erlaubt es die langen, ununterbrochenen Läufe erst.
Was dagegen hilft
Die Lösung liegt nicht darin, Bedienhilfen abzuschalten. Das würde Menschen treffen, die auf sie angewiesen sind, und den eigentlichen Weg nicht einmal schließen. Die Lösung sitzt auf dem Server, nicht in der Oberfläche.
- Begrenzung pro Nutzer. Eine sinnvolle Obergrenze, wie oft ein Quiz je Modul und Tag erzeugt werden darf, nimmt dem automatischen Sammeln die Grundlage. Dazu passen ansteigende Wartezeiten bei auffälliger Häufung.
- Rückmeldung entkoppeln. Wenn die Prüfung, ob eine Antwort stimmt, serverseitig passiert und die Rückmeldung verzögert oder gebündelt kommt, lässt sich der Lösungsschlüssel nicht mehr Frage für Frage auslesen. Begrenzte Wiederholungen je Frage in einem Zeitfenster und häufiger wechselnde Fragenpools tun das Übrige.
- Verhalten beobachten, nicht Technik verbieten. Zeit pro Frage, Länge der Sitzung, der Rhythmus der Eingaben: Ein Mensch und ein Skript unterscheiden sich darin deutlich. Wer serverseitig auf unmögliche Kombinationen aus Tempo und Treffsicherheit achtet, erkennt Automatisierung, ohne Hilfstechnik auszusperren.
- Erfolge an echte Arbeit knüpfen. Abzeichen und Werte, die an praktische, handfeste Übungen gebunden sind, lassen sich nicht per Quiz-Skript erschleichen. Wissensabfragen allein tragen keine belastbare Aussage.
- Sitzungen zeitlich begrenzen. Ein vernünftiges Ablaufdatum und gelegentliche erneute Anmeldung schneiden die langen, unbeaufsichtigten Läufe ab.
Der rote Faden: Wer eine Aussage über Menschen treffen will, darf die Prüfung nicht dem Gerät des Menschen überlassen. Alles, was auf dem Client passiert, kann ein Client nachahmen.
Melden, nicht posten
Hier gilt dasselbe wie bei jedem Fund in fremder Software. Solange der Hersteller nicht nachbessern konnte, ist das kein Blogthema mit Namen und Anleitung. Wer vorher Details samt Plattform veröffentlicht, liefert eine fertige Vorlage für alle, die genau das ausnutzen wollen.
Deshalb ging der Fund zuerst vertraulich an das Sicherheitsteam des Herstellers, mit allen sechs Beobachtungen, ihrer Einordnung nach Schwere und konkreten Empfehlungen. Beim Test wurde ausschließlich das eigene Konto benutzt, kein fremdes Konto und keine fremden Daten berührt, nichts am Programm verändert. Dieser Artikel nennt den Hersteller nicht, nennt die App nicht und verzichtet auf jede Schritt-für-Schritt-Anleitung. So lässt sich die Lehre daraus teilen, ohne irgendjemanden einem offenen Risiko auszusetzen.
Und ja, auch das gehört dazu: Ein Teil der Auswertung lief mit Werkzeugen, die systematisch protokolliert und katalogisiert haben. Das nimmt einem nicht das Nachdenken ab, es macht nur die Fleißarbeit sichtbar, die ein System aushalten muss.
Was man mitnehmen kann
Für alle, die selbst Systeme mit Punkten, Serien oder Bestenlisten bauen:
- Spielmechanik ist ein Sicherheitsthema. Sobald Punkte etwas bedeuten, gibt es einen Anreiz, sie zu erschleichen. Wer eine Zahl zeigt, muss sie schützen.
- Dem Client kann man nichts glauben. Jede Prüfung, die auf dem Gerät des Nutzers stattfindet, lässt sich nachahmen. Die Wahrheit gehört auf den Server.
- Sofortige Rückmeldung plus unbegrenzte Wiederholung ergibt einen Lösungsschlüssel. Zwei einzeln sinnvolle Komfortfunktionen heben zusammen die ganze Abfrage aus den Angeln.
- Barrierefreiheit ist kein Leck. Die Bedienhilfen-Schnittstelle gehört nicht abgeschaltet. Der Schutz gegen Automatisierung gehört serverseitig daneben.
- Gefunden heißt nicht gepostet. Erst vertraulich melden, dem Hersteller Zeit geben, dann reden, und auch dann ohne Namen und ohne Anleitung, solange nichts behoben ist.
Aus einem Quiz nebenbei wurde so ein kleiner Beleg dafür, dass eine hübsche Bestenliste ohne serverseitige Kontrolle vor allem eines misst: wie fleißig ein Skript ist.
Weiterlesen: Wenn der Angreifer ein LLM ist · Ein Token, der überall funktioniert: eine Mobilitäts-App im Test · Reihenweise gemeldet: eine Runde Open-Source-Reviews