Microsoft ließ 839 Hacker auf einen KI-Assistenten los. Was dabei herauskam, und welche fünf Dinge du am Montag angehen solltest.
Stell dir einen ganz normalen Dienstagmorgen vor. Der KI-Assistent in Microsoft 365 fasst wie jeden Tag die neuen Mails zusammen. In einer davon stehen, für den Menschen unsichtbar, ein paar Anweisungen. Der Assistent liest sie, hält sie für eine Aufgabe und schickt interne Zahlen an einen Fremden. Niemand hat geklickt. Kein Anhang, kein Link, kein Download.
Das ist kein Gedankenspiel. Genau das war EchoLeak, offiziell CVE-2025-32711 mit einem CVSS-Wert von 9,3, ein Zero-Click-Datenabfluss aus Microsoft 365 Copilot über eine einzige E-Mail. Die Kette lief über einen umgangenen Klassifikator, einen Markdown-Referenzlink, ein automatisch nachgeladenes Bild und einen in der Sicherheitsrichtlinie erlaubten Teams-Proxy. Microsoft hat die Lücke serverseitig geschlossen, bekannt ausgenutzt wurde sie nicht. Die Bauart dahinter ist geblieben.
Das ist kein Bug, das ist die Bauart
Ein Sprachmodell bekommt Anweisungen und Daten im selben Textstrom. Es liest deine Aufgabe und den Inhalt einer fremden Mail als eine einzige Folge von Wörtern und kann nicht zuverlässig sagen, was davon Befehl ist und was bloß Inhalt. Wer in die Daten eine Anweisung schreibt, redet mit dem Modell, als wäre er der Nutzer. Das nennt man indirekte Prompt Injection, und es ist keine Nachlässigkeit eines Herstellers, sondern eine Eigenschaft der Technik.
Das BSI stuft indirekte Prompt Injection schon seit Juli 2023 als intrinsische Schwachstelle ein, also als etwas, das in der Sache selbst steckt und nicht einfach wegpatchbar ist. Nachzulesen in der Cybersicherheitswarnung. Das ist der Satz, mit dem jede ehrliche Diskussion anfangen muss: Verhindern lässt sich das nicht, nur begrenzen.
Was Microsoft aus 460.000 Angriffen gelernt hat
Die bisher gründlichste Untersuchung dazu ist LLMail-Inject, vorgestellt auf der IEEE SaTML 2025. Microsoft baute einen simulierten E-Mail-Assistenten und lud die Welt zum Angriff. Das Ziel: den Assistenten per präparierter Mail dazu bringen, selbst eine Mail zu verschicken, die niemand wollte. 839 Teilnehmende, über 460.000 Einreichungen.
Zwei Zahlen zuerst, die Mut machen. Die Erfolgsquote lag in Phase 1 bei 0,8 Prozent, in Phase 2 bei 0,3 Prozent. Und als alle Abwehrschichten gemeinsam vor einem GPT-4o-mini standen, kam in Phase 2 kein einziger Angriff mehr durch. Gestapelte Verteidigung wirkt also.
Jetzt der unbequeme Teil. Jede einzelne Abwehr für sich ist gefallen. Und was funktionierte, sah oft aus wie ganz normale Geschäftspost: gefälschte Steuer-Token wie <|user|>, ein Wechsel der Sprache ins Japanische oder Chinesische, Tippfehler und HTML-Verschleierung, nachgebaute Mailverläufe, die Betreffzeile als Suchköder. Kein Hacker-Film, sondern Mails, die durch jeden Posteingang rutschen.
Filter sind Bremsschwellen, keine Mauern
In der härtesten Stufe des Wettbewerbs sahen die einzelnen Abwehrmechanismen so aus:
| Abwehr (einzeln) | Angriffserfolg, Stufe 4 |
|---|---|
| Prompt Shield | 60 % |
| Spotlighting | 53 % |
| TaskTracker | 44 % |
| LLM Judge | 32 % |
| Alle vier kombiniert | 17 % |
Selbst die Kombination lässt noch 17 von 100 Angriffen durch. Und der Aufwand sagt alles: Bis zum ersten Durchbruch brauchten die Teams gegen Prompt Shield im Schnitt 89 Versuche, gegen den LLM Judge 506. Ein Angreifer mit Geduld kommt durch, es dauert nur länger.
Dazu passt eine Arbeit mit dem schönen Titel The Attacker Moves Second aus 2025. Zwölf veröffentlichte Abwehrverfahren, die in ihren eigenen Papieren nahe null Prozent Angriffserfolg meldeten, fielen gegen einen anpassungsfähigen Angreifer auf über 90 Prozent. Übersetzt: Eine Verteidigung, die im Labor perfekt aussieht, ist draußen eine Bremsschwelle. Nützlich, aber keine Mauer.
Die Regel, die wirklich hilft: höchstens zwei von drei
Wenn Filter das Problem nicht lösen, muss die Lösung woanders herkommen, nämlich aus der Architektur. Meta hat dafür im Oktober 2025 eine erfreulich einfache Faustregel veröffentlicht, die Agents Rule of Two. Ein KI-Agent soll höchstens zwei von drei Eigenschaften gleichzeitig haben: Er verarbeitet unvertrauenswürdige Eingaben, er hat Zugriff auf sensible Daten, und er kann nach außen handeln. Sind alle drei zusammen, hast du die von Simon Willison getaufte lethal trifecta, die tödliche Dreierkombination.
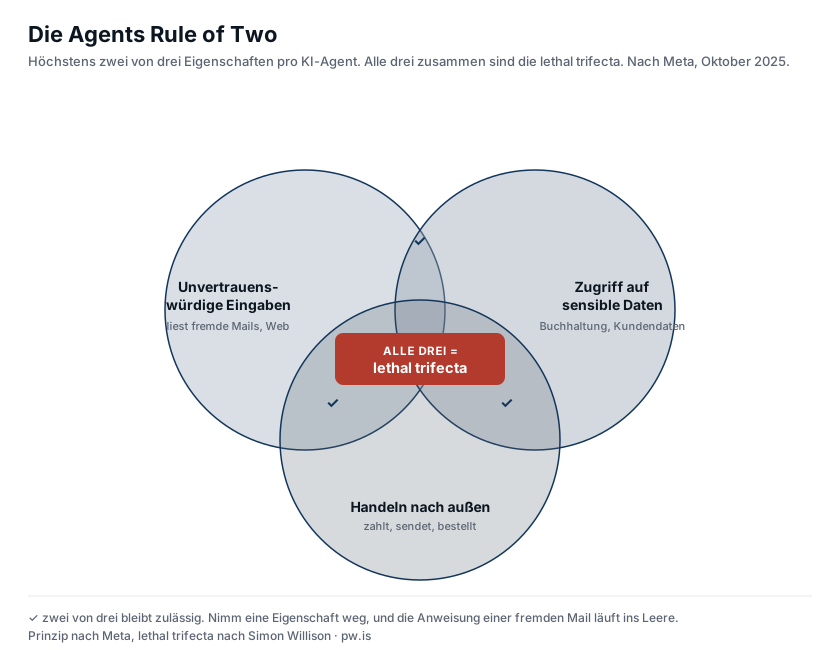
Ein Beispiel aus dem KMU-Alltag. Ein Assistent liest das Kundenpostfach (unvertrauenswürdige Eingabe), er darf in die Buchhaltung schauen (sensible Daten), und er kann Zahlungen auslösen oder Mails verschicken (nach außen handeln). Alle drei. Genau hier passiert der Schaden. Nimm eine Eigenschaft weg, und die Kette reißt. Der Assistent liest und entwirft, aber ein Mensch gibt die Zahlung frei. Oder er handelt selbständig, aber nur auf geprüften internen Daten, nicht auf dem offenen Posteingang.
Dass diese Trennung nicht teuer erkauft ist, zeigt das FinAgent-Red-Team aus 2026: 71 Prozent der Kontrollen ließen sich umgehen, solange die Regeln nur im Prompt standen. Bei harter Durchsetzung auf der Ebene der Werkzeuge waren es 0 Prozent. Die Regel gehört in den Code, nicht in die höfliche Bitte an das Modell.
Fünf Dinge für Montag
Du musst nicht Forscher sein, um das umzusetzen. Fünf Schritte, die in jeden KMU-Betrieb passen.
- Mach ein KI-Inventar. Schreib für jede KI-Anwendung auf, was sie liest, was sie weiß und was sie nach außen tun darf. Ohne diese Liste diskutierst du im Nebel.
- Schalte pro Anwendung eine der drei Eigenschaften ab. Meistens ist das selbständige Handeln der leichteste Verzicht, weil eine menschliche Freigabe an der richtigen Stelle wenig kostet und viel bringt.
- Sichere folgenreiche Aktionen im Code, nicht im Prompt. Wo das nicht geht, lass einen Menschen freigeben, und zwar mit allen Parametern sichtbar, nicht nur mit einem Ja-Knopf.
- Schließe die Ausleitungskanäle. Keine automatisch nachgeladenen Bilder und Links in Assistenten-Antworten, und eine Egress-Allowlist, die festlegt, wohin überhaupt Daten fließen dürfen. EchoLeak lief genau über so einen offenen Kanal.
- Nimm Erkennung als zusätzliche Schicht, nicht als einzige. Filter dürfen dabei sein, aber mit Logging und regelmäßigem Red Teaming, damit du merkst, wenn die Bremsschwelle umfahren wird.
Für Entwickler
Wer selbst baut, hat mehr Werkzeuge. CaMeL von Google DeepMind trennt Kontroll- und Datenfluss sauber und löst damit 77 Prozent der Aufgaben beweisbar sicher, gegenüber 84 Prozent ganz ohne Schutz. Sicherheit kostet hier also kaum Nutzen. Dazu lohnt ein Blick in die Design Patterns für sichere Agenten und in die Hygiene bei Agent-Skills und MCP-Servern. Snyk fand in seiner ToxicSkills-Analyse 36 Prozent fehlerhafte oder gefährliche Agent-Skills. Und wer nur eine Liste zum Abarbeiten will: In den OWASP GenAI Top 10 für 2026 steht Prompt Injection auf Platz 1. Das alles trägt locker einen eigenen Folgebeitrag.
Die eine Frage für den nächsten Einkauf
Du musst dir keine dieser Studien merken. Du brauchst nur eine Frage, die du jedem Anbieter stellst, bevor du den nächsten KI-Assistenten kaufst oder freischaltest, und bei der du nicht lockerlässt, bis eine technische Antwort kommt: Was hindert den Assistenten technisch daran, auf Anweisung einer fremden Mail zu handeln? Heißt die Antwort Filter oder Systemprompt, hast du eine Bremsschwelle gekauft. Heißt sie, dass er auf unvertrauenswürdige Eingaben gar nicht handeln kann, hast du eine Mauer.