Wenn ein KI-Agent den Code schreibt, ist die Frage nicht, ob er Fehler macht, sondern wo sie hängen bleiben. Wie ich die Pipeline für ein internes CRM mit personenbezogenen Daten gebaut habe: drei Prüfstufen, Deploy nur per Pull, Daten, die nie ersetzt werden, und ein Angriffsscan gegen eine Wegwerf-Instanz. Mit echter Konfiguration und den Lücken, die noch offen sind.
Das CRM, um das es hier geht, entsteht im Vibe Coding. Ich beschreibe, was die Anwendung können soll, ein KI-Agent schreibt den Code, ich prüfe das Ergebnis im Browser. Seit April 2026 sind so 452 Commits zusammengekommen: Kontakte, Veranstaltungen, Reisekosten, Mailings, eine Schnittstelle für weitere KI-Werkzeuge. Die Anwendung hängt an einer Oracle-Datenbank mit Mitgliederdaten und an Microsoft 365. Alles darin ist personenbezogen.
Der Agent arbeitet schnell und meistens gut. Aber er hat auf meinem Rechner weitreichende Rechte, er committet, er pusht, und er hat keine Angst vor der Produktion. Ein Satz im Prompt wie „sei vorsichtig mit der Datenbank“ ist eine Bitte, keine Sicherung. Spätestens wenn ein Kontext zu lang wird oder ein Text von außen eine Prompt Injection enthält, ist die Bitte vergessen.
Deshalb gilt für die ganze Pipeline ein Grundsatz: Jede Regel, die wichtig ist, wird technisch durchgesetzt, und zwar an einer Stelle, an die der Agent nicht herankommt. Die Anweisungen an die KI stehen trotzdem im Repository, in einer CLAUDE.md und einer Commit-Policy. Sie sorgen dafür, dass der Agent die Regeln kennt. Durchgesetzt werden sie woanders.
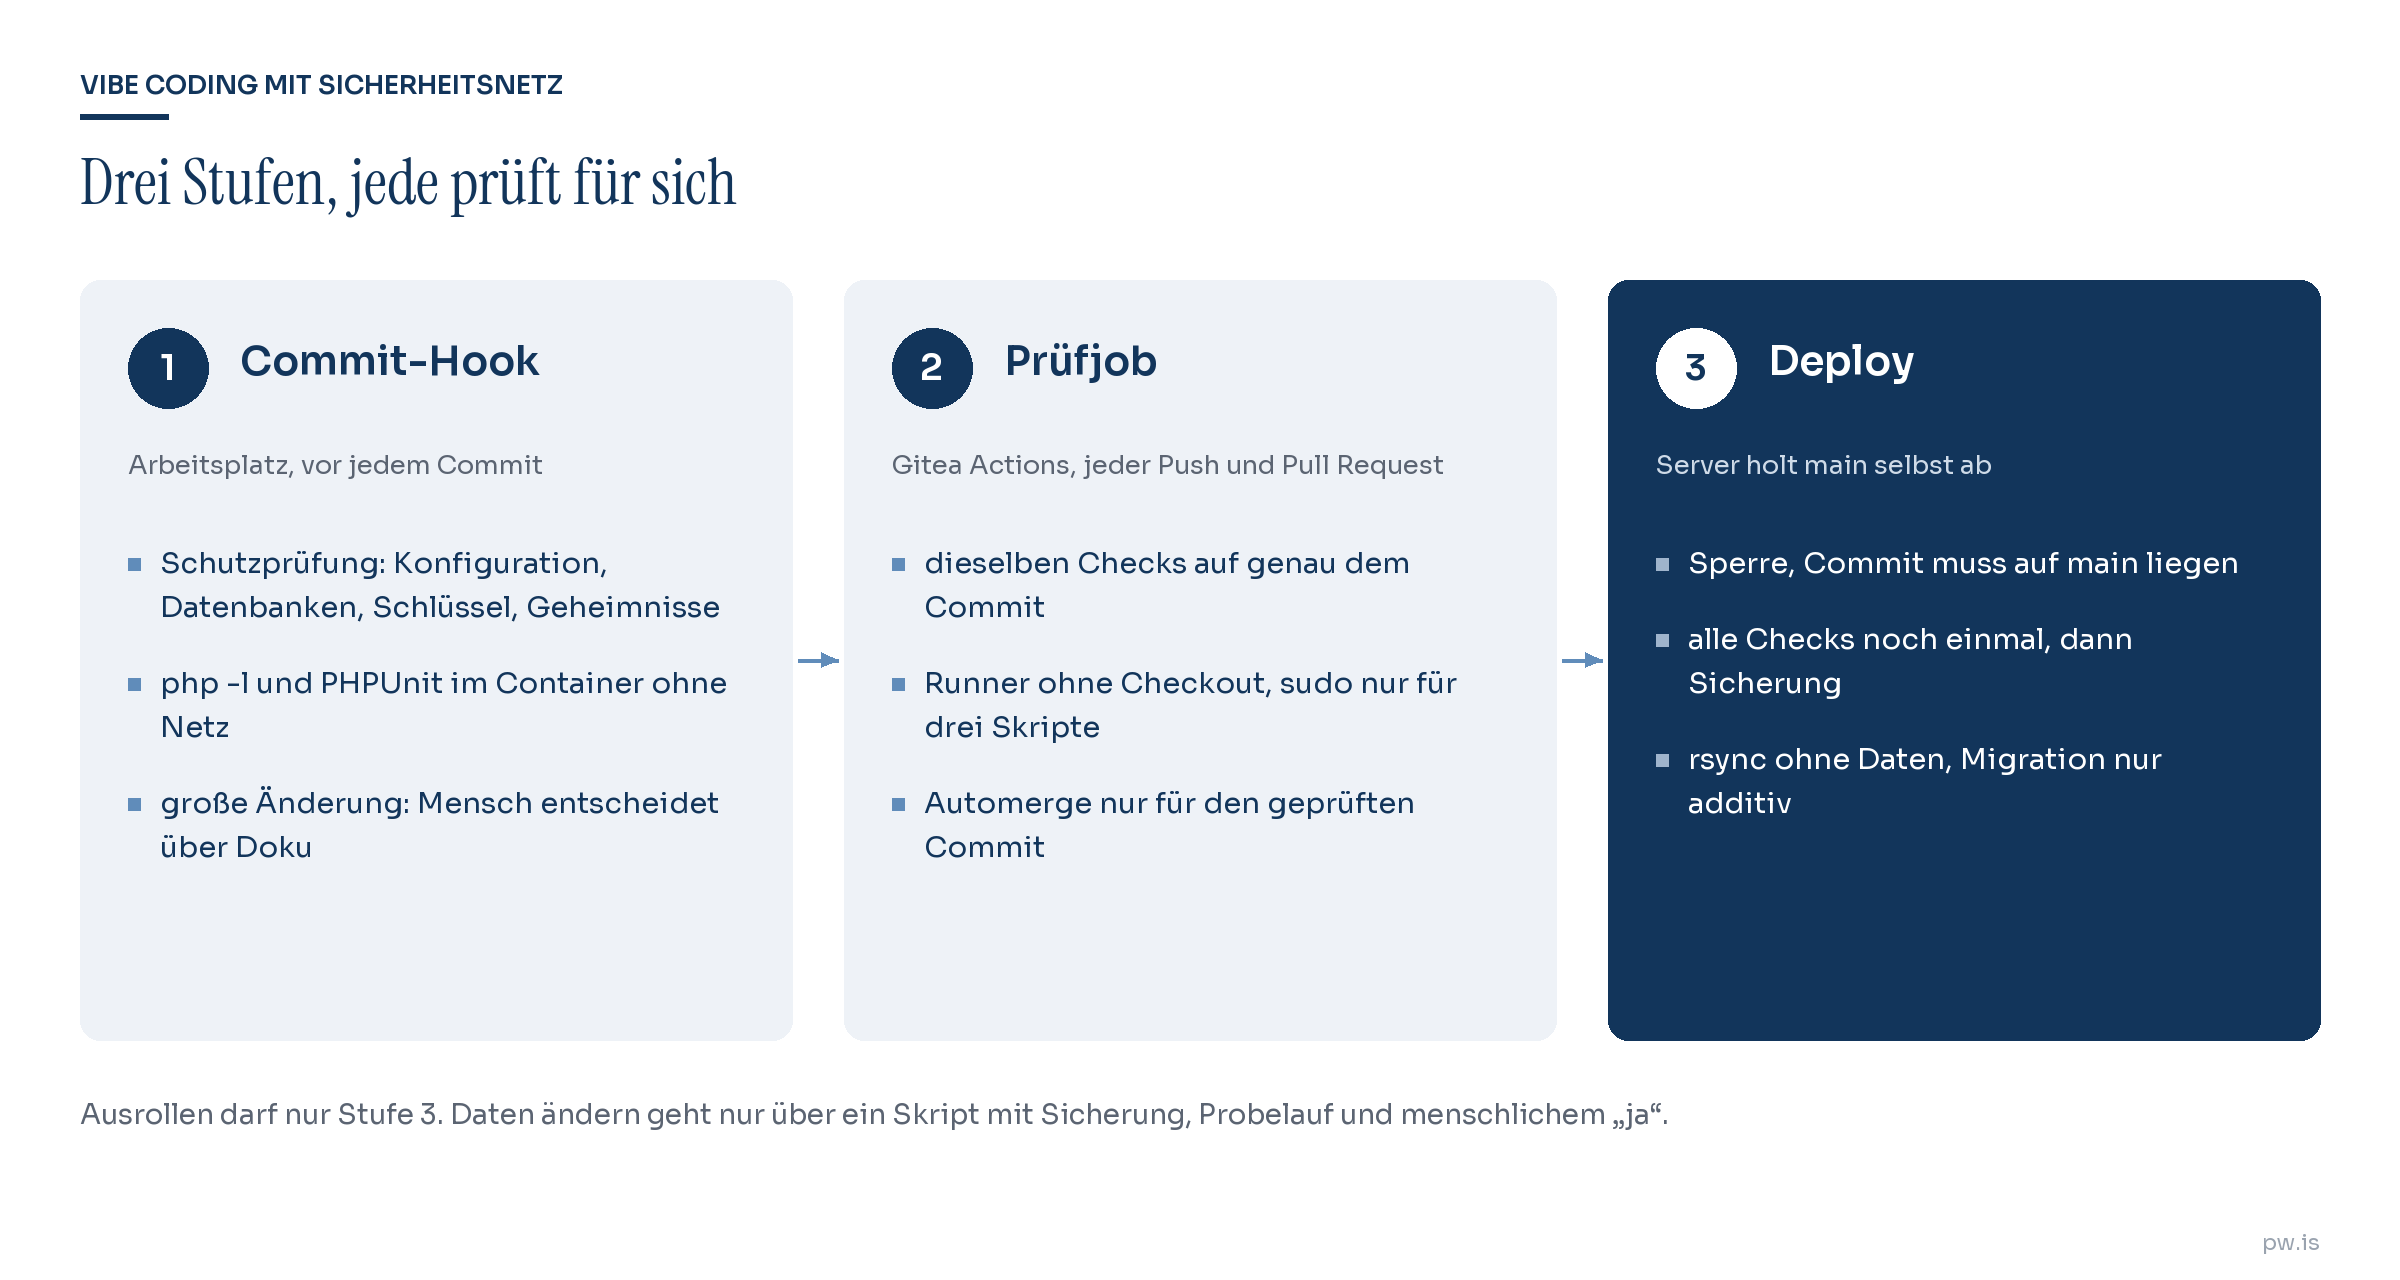
Die Grundsätze
Bevor es um Werkzeuge geht, die sechs Entscheidungen, aus denen sich alles andere ergibt:
1. Niemand lädt Code hoch. Der Server holt sich den Stand selbst aus dem Git-Server. Es gibt keinen Weg, ein lokales Arbeitsverzeichnis in die Produktion zu kopieren, auch nicht für mich. 2. Jede Prüfung läuft mehrfach. Vor dem Commit, im Prüfjob und noch einmal direkt vor dem Deploy. Wer eine Stufe umgeht, scheitert an der nächsten. 3. Geprüft wird genau der Commit, der live geht. Nicht der Arbeitsstand, nicht „ungefähr dieser Branch“, sondern eine Commit-ID. 4. Die Live-Datenbank wird nie ersetzt. Schema nur additiv, Daten nur über ein Skript mit Sicherung, Probelauf und Rückfrage. 5. Geheimnisse und Personendaten kommen nie ins Repository. Die Konfiguration liegt nur auf dem Server. 6. Angriffe nur auf Wegwerf-Instanzen. Der dynamische Scan schießt auf einen Container ohne Netz und ohne echte Daten, nie auf die Produktion.
Stufe 1: der Commit-Hook
Vor jedem Commit läuft ein Git-Hook. Er prüft exakt den gestagten Stand, nicht das, was zufällig sonst noch im Arbeitsverzeichnis liegt. Dafür werden die Dateien aus dem Git-Index in ein leeres Verzeichnis ausgecheckt:
git ls-files -z -- crm tests tools | tr '\0' '\n' | grep -Ev "$EXCLUDE_RE" | tr '\n' '\0' \
    | git checkout-index -z --stdin --prefix="$STAGE/"
Drei Prüfungen laufen dann nacheinander.
Die Schutzprüfung. Ein Shell-Skript blockiert Dateien, die nie ins Repository gehören: Konfiguration, SQLite-Datenbanken, Backups, Uploads, .env, private Schlüssel und alles über 5 MB. Dazu sucht es im Inhalt nach privaten Schlüsseln und nach Geheimnissen, die per define() gesetzt werden:
VERBOTEN='(^|/)config\.php$|\.sqlite(-wal|-shm)?$|\.db$|^backups/|^crm/uploads/|\.env$|(^|/)id_(rsa|ed25519)$|\.(pem|key|pfx|p12)$'

grep -Eio "define\(\s*'[A-Z0-9_]*(SECRET|PASSWORD|_PW|PASS|API_KEY|TOKEN)'\s*,\s*'[^']{6,}'"
Der Trick beim zweiten Muster: Platzhalter in Beispieldateien sind erlaubt, solange sie nur aus Großbuchstaben bestehen, etwa 'IHR_PASSWORT'. Ein echtes Passwort enthält fast immer einen Kleinbuchstaben und fällt auf. Das ist grob, aber es fängt genau den Fehler, den ein Agent macht, wenn er „schnell mal zum Testen“ einen Schlüssel in den Code schreibt. Syntax und Tests. php -l auf alle PHP-Dateien und die PHPUnit-Suite. Beides läuft nicht lokal, sondern auf einem Prüf-Server in einem Docker-Container mit --network none. Kein Test kann Microsoft Graph, Oracle oder einen Mailserver erreichen, selbst wenn der Agent einen schreibt, der es versucht. Die Code-Kopie liegt dort in einem eigenen Ordner, und das Skript bricht ab, wenn dieser Ordner im Webroot liegen würde.
Ein Hook auf dem eigenen Rechner lässt sich mit git commit --no-verify überspringen. Das steht ausdrücklich verboten in den Anweisungen an den Agenten, ebenso wie das Abschwächen oder Löschen von Tests, um einen Commit durchzubekommen. Aber darauf verlasse ich mich nicht. Der Hook ist die schnelle Rückmeldung, nicht die Sicherung. Die Sicherung kommt in Stufe 2 und 3.
Ein Mensch muss antworten. Ein zweiter Hook auf die Commit-Nachricht hält große Änderungen an einer Ansicht an, wenn die Dokumentation fehlt: ab 150 geänderten Zeilen oder einer neuen Datei ab 50 Zeilen. Weiter geht es nur mit einer Zeile Doku: aktualisiert, Doku: folgt oder Doku: nicht nötig, <Grund>. Die Anweisung an den Agenten dazu ist eindeutig: Diese Zeile setzt er nie selbst, er fragt mich. Das ist kein Sicherheits-Check im engeren Sinn, aber es ist der Moment, in dem ich bei großen Umbauten zwingend draufschaue.
Stufe 2: der Prüfjob in Gitea Actions
Jeder Push auf einen beliebigen Branch und jeder Pull Request löst einen Prüfjob aus. Der Git-Server ist ein selbst betriebenes Gitea, der Runner läuft auf dem Anwendungsserver. Die Workflow-Datei ist bewusst kurz:
jobs:
  checks:
    if: github.event_name == 'pull_request' || github.ref != 'refs/heads/main'
    runs-on: app-server
    steps:
      - name: php -l und PHPUnit
        run: sudo /opt/app/bin/ci-check.sh ${{ github.event.pull_request.head.sha || github.sha }}

  automerge:
    needs: checks
    if: >-
      (github.event_name == 'pull_request'
        && github.event.pull_request.head.repo.full_name == github.repository
        && !github.event.pull_request.draft)
      || (github.event_name == 'push' && startsWith(github.ref, 'refs/heads/auto/'))
    runs-on: app-server
    steps:
      - run: /opt/app/bin/gitea-automerge.sh

  deploy:
    if: github.event_name == 'push' && github.ref == 'refs/heads/main'
    runs-on: app-server
    steps:
      - run: sudo /opt/app/bin/server-deploy.sh ${{ github.sha }}
Drei Dinge daran sind Absicht.
Der Runner checkt nichts aus und darf fast nichts. Er läuft als eigener Systemnutzer ohne Login-Shell und darf per sudo genau drei Skripte ausführen: prüfen, deployen, sichern. Die sudoers-Datei dafür hat eine Zeile. Was der Runner nicht kann, kann auch ein manipulierter Workflow nicht.
Gemergt wird nur der geprüfte Commit. Grüne Pull Requests gehen automatisch per Squash nach main. Das Merge-Skript prüft vorher, dass der Pull Request nicht aus einem Fork kommt, kein Entwurf ist, nach main zielt und noch genau auf dem Commit steht, der geprüft wurde. Gitea bekommt die Commit-ID beim Merge mit (head_commit_id). Hat jemand in der Zwischenzeit nachgeschoben, wird nichts gemergt, der neuere Lauf entscheidet.
Der Agent braucht keinen Token. Ein Push auf einen Branch mit dem Präfix auto/ legt den Pull Request selbst an. So kann der Agent eine Änderung bis in die Produktion bringen, ohne je einen Zugang zum Git-Server in der Hand zu haben. Wer etwas nicht sofort live haben will, arbeitet auf einem Branch ohne dieses Präfix oder öffnet den Pull Request als Entwurf.
Der Branch main selbst ist geschützt: Push nur für freigegebene Personen, kein Force-Push, kein Löschen, auch nicht für Admins. Merge nur mit grünem Prüfjob.
Stufe 3: der Deploy auf dem Server
Der Deploy ist ein einziges Skript, und es ist der einzige Weg in die Produktion. Ausgelöst wird es von Gitea Actions bei jedem Push auf main, als Rückfallebene alle fünf Minuten von einem systemd-Timer, oder von Hand. Auch von Hand wird nichts hochgeladen, der Aufruf stößt nur den Server an. Der Ablauf:
1. Sperre. flock verhindert zwei Deploys gleichzeitig. 2. Holen und prüfen, ob der Commit auf main liegt. Ein Commit, der nicht Vorfahre von main ist, wird nicht deployt. Ältere Stände nur mit --force. 3. Alle Checks noch einmal, auf genau diesem Commit, frisch aus git archive in ein eigenes Verzeichnis entpackt. 4. Sicherung der Datenbank als Online-Backup, geprüft mit PRAGMA integrity_check. Scheitert die Sicherung, bleibt der Server unverändert. 5. Abgleich per rsync --delete --checksum. Im Repository gelöschte Dateien verschwinden auch auf dem Server. Ausgenommen ist eine feste Liste: Konfiguration, Datenbank, Schlüsseldateien, Belege, Uploads. 6. Migration als Webserver-Nutzer, danach ein Vergleich des Schemas vorher und nachher im Protokoll.
Zwei Details, die sich bewährt haben. Ein fehlgeschlagener Commit wird vom Timer nicht alle fünf Minuten neu geprüft, sondern vermerkt. Und der Server liest das private Repository mit einem eigenen Deploy Key, der nur Leserechte hat, gegen einen fest hinterlegten Host-Schlüssel des Git-Servers.
Die Datenbank wird nie ersetzt
Der gefährlichste Satz, den ein Agent sagen kann, ist „ich setze die Datenbank kurz neu auf“. Deshalb gibt es zwei harte Regeln.
Migrationen nur additiv. Schemaänderungen laufen als Migration im Code. Ein Test liest den Quelltext dieser Migrationsfunktion und schlägt fehl, sobald darin etwas Zerstörerisches steht:
private const VERBOTEN = [
    'DROP TABLE'    => '/\bDROP\s+(TABLE|INDEX|VIEW|TRIGGER)\b/i',
    'DROP COLUMN'   => '/\bALTER\s+TABLE\s+\w+\s+DROP\b/i',
    'RENAME'        => '/\bALTER\s+TABLE\s+\w+\s+RENAME\b/i',
    'DELETE'        => '/\bDELETE\s+FROM\b/i',
    'UPDATE'        => '/\bUPDATE\s+\w+\s+SET\b/i',
    'TRUNCATE'      => '/\bTRUNCATE\s+TABLE\b/i',
    'REPLACE INTO'  => '/\b(INSERT\s+OR\s+REPLACE|REPLACE)\s+INTO\b/i',
];
Das ist ein Test über Code statt über Verhalten, und genau das ist der Punkt. Er hält den Agenten auf, bevor eine Migration überhaupt läuft.
Datenänderungen nur über ein Skript. Wer Daten ändern muss, schreibt das SQL in eine Datei und ruft ein Skript auf. Es sichert die Datenbank, führt das SQL in einer Transaktion aus, zeigt die Zahl der geänderten Zeilen und rollt zurück. Erst nach einem getippten „ja“ läuft es wirklich, wieder in einer einzigen Transaktion, danach ein Integritätscheck. Mit --probe gibt es nur den Probelauf. Für einen Agenten heißt das: Er kann eine Änderung vorbereiten und den Probelauf zeigen, aber das „ja“ kommt von mir.
Sicherungen entstehen nur auf dem Server, nachts, vor jedem Deploy und vor jeder Datenänderung, jeweils 30 Stück oder 30 Tage. Kopien der Produktivdatenbank auf einem Arbeitsplatzrechner gibt es nicht.
Tests als Sicherheitsgurt
Die Suite hat inzwischen 541 Testfälle in 65 Dateien. PHPUnit ist streng eingestellt: Warnungen und „riskante“ Tests ohne Prüfung lassen den Lauf scheitern. Eine Regel aus der Policy ist für Vibe Coding besonders wichtig: Neue Logik in Rechten, Freigaben, Beträgen und beim Datenzugriff über IDs bekommt Tests im selben Commit. Genau dort machen KI-Agenten die teuersten Fehler, weil der Code plausibel aussieht und trotzdem fremde Datensätze herausgibt.
Ein paar Beispiele aus der Schnittstelle für KI-Werkzeuge zeigen, wie diese Tests aussehen: Ein falscher Schlüssel wird abgelehnt, ein deaktivierter auch, ein zu kurzer auch. Wer statt des Schlüssels dessen gespeicherten Hash schickt, kommt nicht rein. Eine manipulierte Sitzungs-ID wird abgelehnt. Fehlt die Schlüsseldatei ganz, ist alles gesperrt statt alles offen. Ein weiterer Test prüft, dass die Testroutine der Anwendung ohne Anmeldung nichts ausgibt und normale Nutzer abweist.
Und ein Test vergleicht die Konfigurationsvorlage mit der Testkonfiguration: Beide müssen dieselben Konstanten definieren, und in der Vorlage darf kein echtes Geheimnis stehen.
Der Sicherheitsscan
Neben den Pflicht-Checks gibt es einen Sicherheitsscan. Er läuft auf dem Prüf-Server in Containern und besteht aus vier Teilen.
Semgrep für die statische Analyse, mit den Community-Regelsätzen für PHP, Security und Secrets und drei eigenen Regeln. Die wichtigste davon sucht ein Muster, das KI-Agenten gern bauen: ein Löschen über die bloße Datensatz-ID, obwohl die Berechtigung vorher für einen übergeordneten Vorgang geprüft wurde.
  - id: loeschen-nur-ueber-id
    languages: [regex]
    severity: WARNING
    message: >-
      Löschen nur über die Datensatz-ID. Wenn die Berechtigung im Aufrufer für
      einen übergeordneten Datensatz geprüft wird, muss dieser auch in der
      WHERE-Bedingung stehen, sonst können über eine fremde ID Einträge
      anderer Vorgänge gelöscht werden (IDOR).
    pattern-regex: '"DELETE FROM \w+ WHERE id = \?"\)->execute\(\[\$\w+\]\)'
Die beiden anderen eigenen Regeln suchen PHP-Variablen im SQL-Text und eingeschaltetes display_errors.
Gitleaks sucht noch einmal mit einem eigenen Regelwerk nach Zugangsdaten im Code.
OWASP ZAP greift die Anwendung dynamisch an, im Schnellscan mit Spider und passiver Analyse, im Vollscan zusätzlich aktiv. Ziel ist eine Wegwerf-Instanz: ein Apache-Container mit Testkonfiguration und leerer Datenbank in einem Docker-Netz, das mit --internal angelegt ist, also weder Internet noch Intranet erreicht. Damit ZAP auch hinter den Microsoft-Login kommt, legt ein kleines Skript im Container eine Testsitzung mit allen Rollen an, mit einer zufälligen Sitzungs-ID pro Lauf. Die Scan-Pläne enthalten ausdrücklich die Warnung, sie nie gegen die Produktion laufen zu lassen. Ein aktiver Scan schickt Formulare ab.
Eine Webroot-Prüfung fragt per HEAD-Anfrage ab, ob Datenbank, Token-Cache, Schlüsseldateien, Upload-Ordner oder Hilfsdateien ohne Login abrufbar sind, und ob die Security-Header gesetzt sind. Diese Prüfung läuft im Scan gegen die Testinstanz und darf, weil sie nur Statuscodes liest, auch gegen die Produktion laufen.
Was das bringt, zeigt der erste Scan vom 2. Oktober. Ein Standard-Apache liefert jede Datei aus, die im Webroot liegt. In der Testinstanz waren 11 von 16 geprüften Pfaden ohne Anmeldung abrufbar, darunter die Datenbankdatei und der Token-Cache für Microsoft Graph. Vierzig Minuten später, mit einer Apache-Härtung, waren es null. Die Härtung liegt seitdem auch auf dem Server, und eine zweite Konfiguration hält die Testinstanz auf demselben Stand.
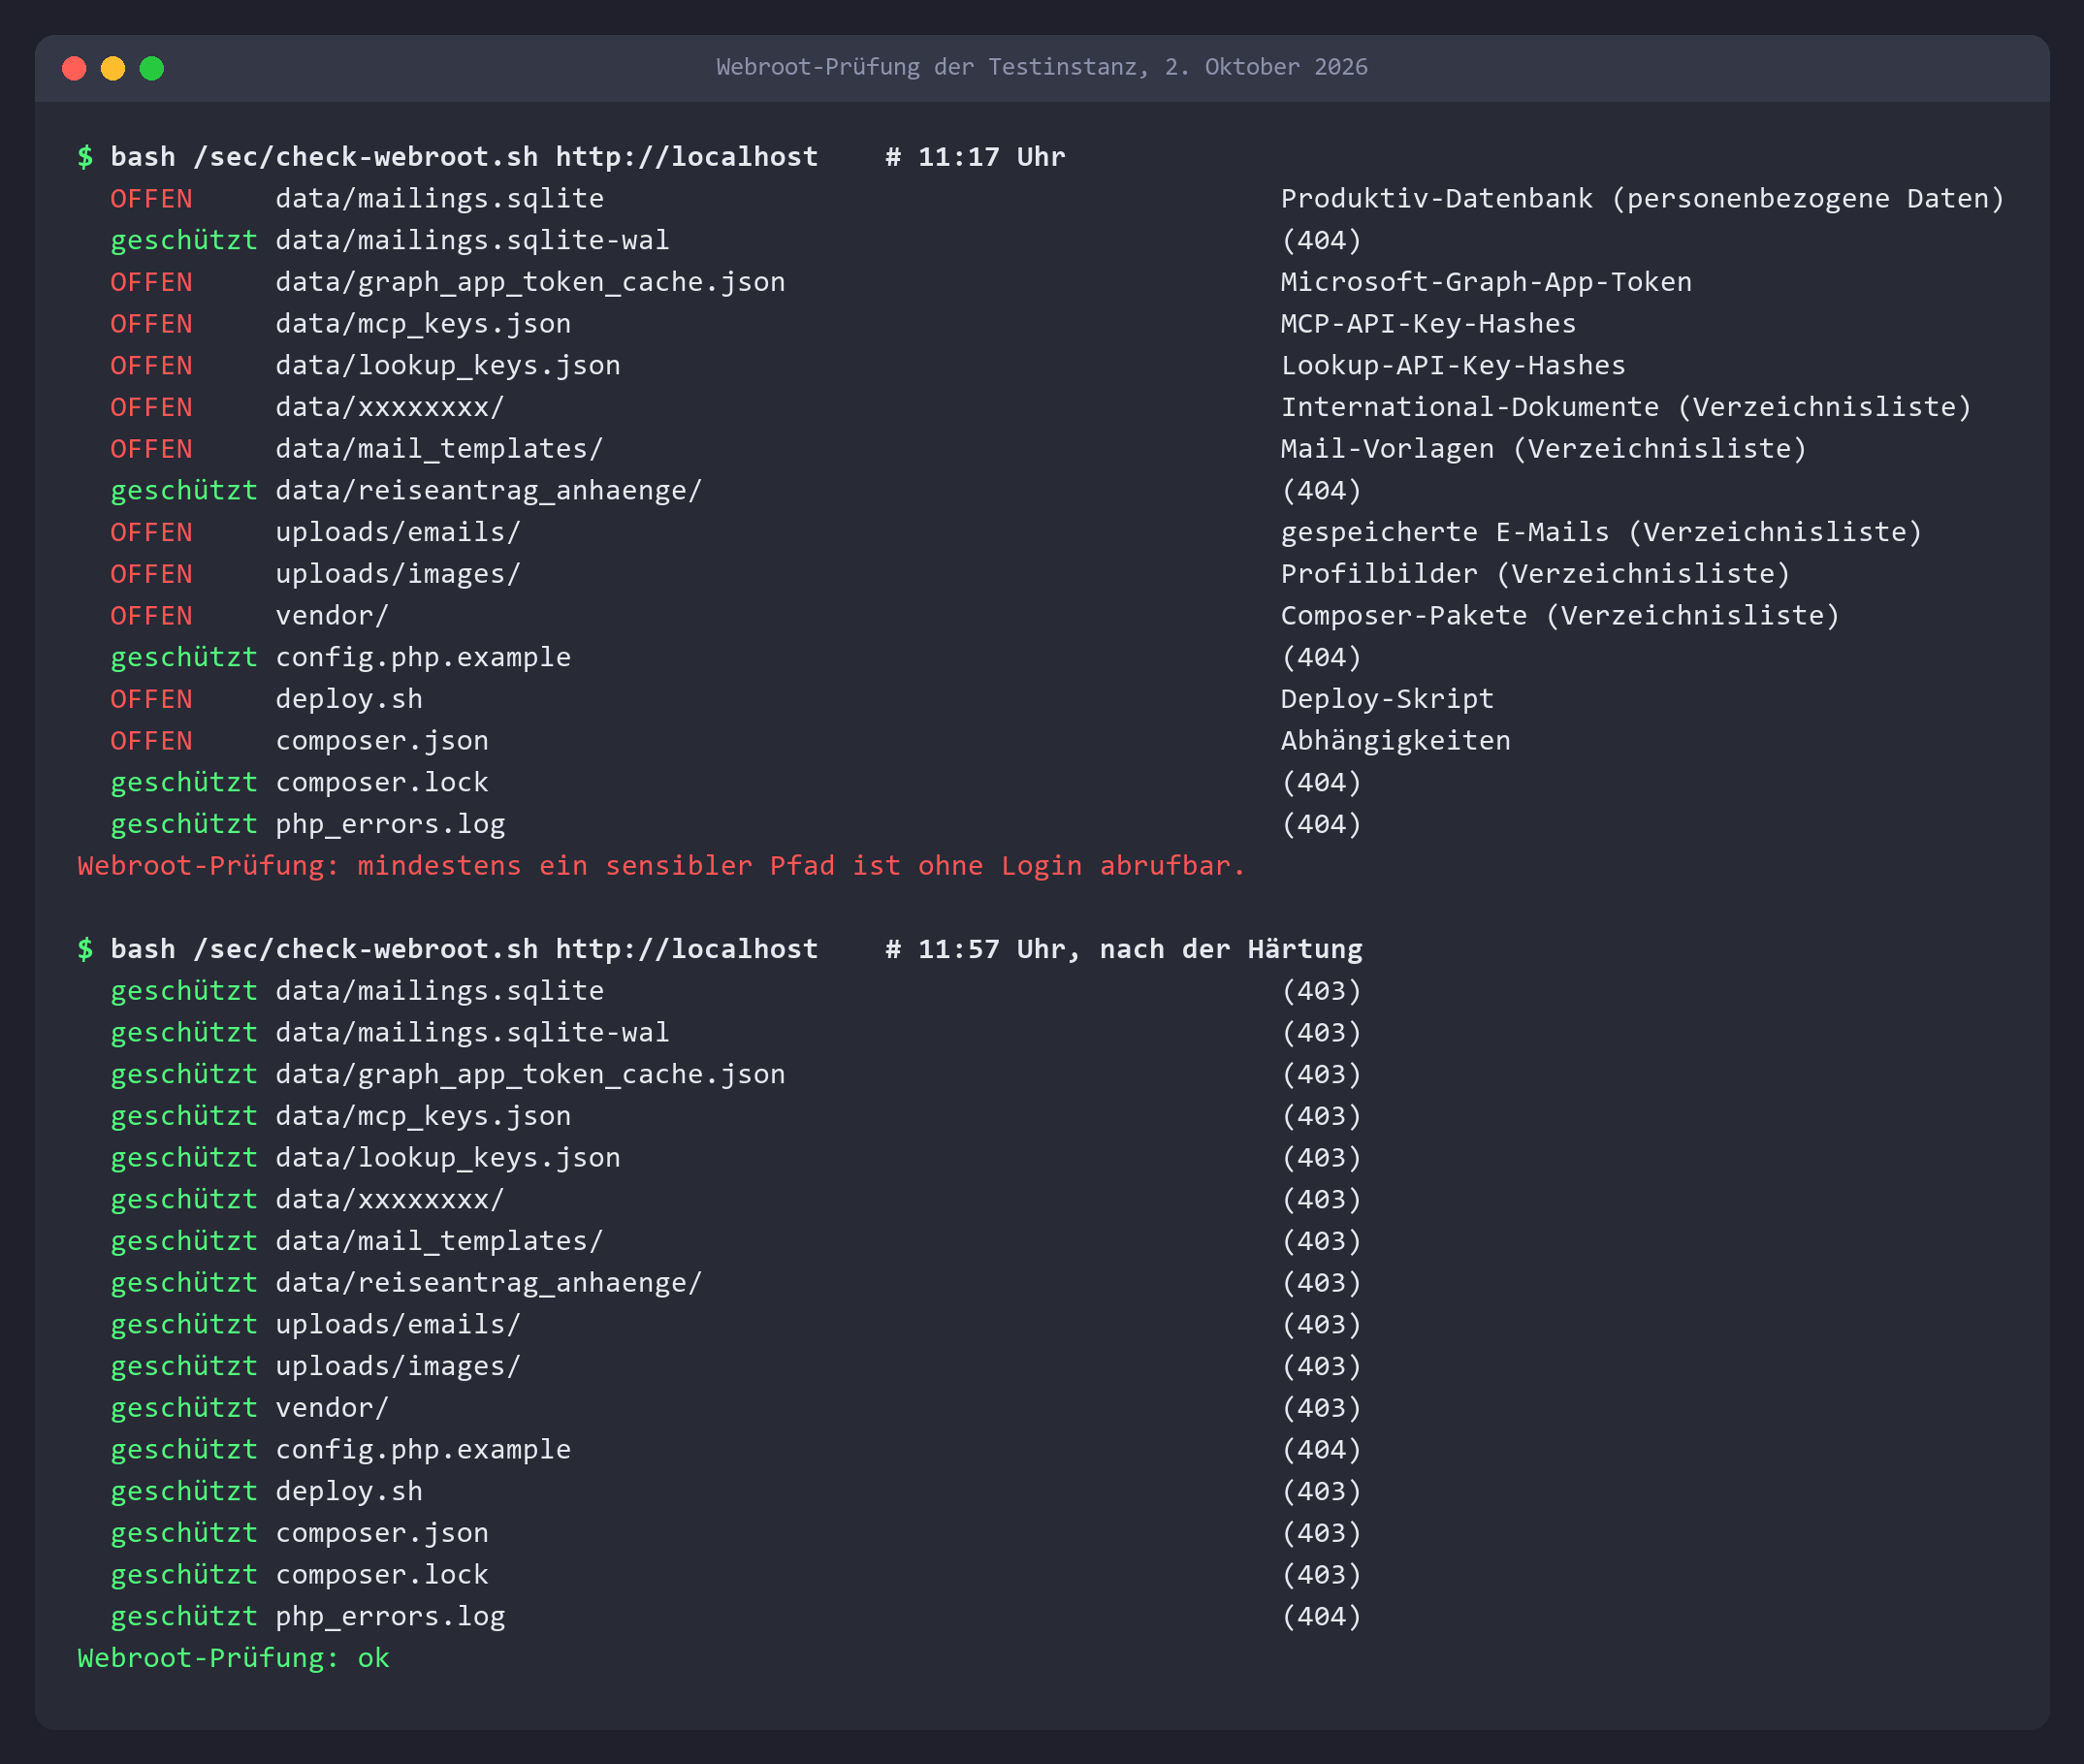
Die übrigen Zahlen aus diesem ersten Scan, damit niemand glaubt, Vibe Coding liefere sauberen Code: Semgrep meldete 59 Stellen, 17 davon als Fehler eingestuft. Am häufigsten traf die eigene IDOR-Regel mit 19 Funden, dann ungefilterte Ausgabe von Anfragedaten mit 16. ZAP fand sechs Probleme mittlerer Stufe, unter anderem fehlende CSRF-Token, fehlende Content Security Policy und fehlenden Schutz gegen Clickjacking. Die Security-Header kamen drei Tage später dazu, eine Weiterleitung von HTTP auf HTTPS ebenso, beides mit eigener Prüfung in der Webroot-Kontrolle. Nicht jeder Semgrep-Fund ist ein echter Fehler. Aber jeder wird angesehen: Funde der Stufe Hoch und Mittel werden vor dem nächsten Deploy behoben oder mit Begründung als Ausnahme festgehalten.
Was noch nicht gut ist
Maximaler Fokus auf Sicherheit heißt auch, die eigenen Lücken aufzuschreiben. Beim Zusammentragen für diesen Artikel sind mir einige aufgefallen.
Der Prüfjob vertraut dem Code, den er prüft. Das Prüfskript auf dem Server entpackt den zu prüfenden Commit und startet dann das Testskript aus genau diesem Commit, mit Root-Rechten. Wer einen Branch pushen kann, kann damit Code als root auf dem Server ausführen, bevor irgendein Test etwas sagt. Das gilt auch für den Agenten mit seinem auto/-Branch. Die Regel dahinter ist einfach und ich habe sie selbst verletzt: Das Werkzeug, das prüft, darf nie aus dem kommen, was geprüft wird. Prüfskripte gehören fest auf den Server, die Installation der Testabhängigkeiten in den Container ohne Root, und der Runner selbst sollte keine Root-Rechte bekommen, auch nicht für ein einziges Skript.
Grün ist kein Review. Automatischer Merge heißt: Eine Änderung an den Deploy-Skripten geht ohne menschlichen Blick live, sobald die Tests grün sind. Die Policy sagt, solche Änderungen seien gründlich durchzusehen. Technisch durchgesetzt ist das nicht. Ein Pfadfilter, der für .gitea/ und die Server-Skripte den automatischen Merge abschaltet, wäre eine Zeile.
Der Scan läuft von Hand. Pflicht-Checks laufen bei jedem Push, der Sicherheitsscan nur auf Aufruf. Die Policy verlangt ihn vor Pushes mit neuen Seiten und Formularen und einmal im Monat vollständig. Ein Agent, der eine neue Seite baut, vergisst das. Zumindest Semgrep und Gitleaks gehören in den Prüfjob.
Die Werkzeuge sind nicht festgenagelt. Gitleaks läuft mit dem Tag latest, Semgrep und ZAP ohne Version, PHPUnit wird ohne Lockfile installiert. Für eine Pipeline, die vor Lieferketten-Angriffen schützen soll, ist das inkonsequent. Container-Images gehören per Digest fixiert, Abhängigkeiten per Lockfile.
Ein Rechte-Skript aus einem Home-Verzeichnis. Der Deploy ruft für das Setzen der Dateirechte ein Skript auf, das im Home-Verzeichnis eines Nutzerkontos liegt, und zwar als root. Wer dieses Konto übernimmt, übernimmt den nächsten Deploy.
Die Content Security Policy ist halb. Sie regelt, wer die Anwendung einbetten darf, aber nicht, welche Skripte laufen dürfen. Die Seiten nutzen Inline-Skripte, und die auszubauen ist Arbeit, die ein Agent gut erledigen könnte, aber noch nicht erledigt hat.
Der Agent darf lokal fast alles. In den lokalen Einstellungen des Agenten steht für die Shell eine Freigabe für alle Befehle. Das ist bequem, und es ist genau der Grund, warum die Sicherungen auf dem Server sitzen müssen und nicht auf meinem Rechner. Zusammen mit dem ersten Punkt ergibt es allerdings eine Kette, die ich nicht stehen lassen will.
Zum Mitnehmen
Wer selbst eine Anwendung im Vibe Coding baut, kann diese Liste in einem Nachmittag abarbeiten:
- Die KI bekommt Regeln als Text, die Durchsetzung passiert auf einem System, auf das sie keinen Zugriff hat.
- Deploy nur per Pull vom Server, nie per Upload. Geprüft und ausgerollt wird eine Commit-ID.
- Jede Prüfung läuft vor dem Commit, im CI und direkt vor dem Deploy.
- Tests laufen in einem Container ohne Netz.
- Schutzprüfung im Commit: Konfiguration, Datenbanken, Schlüssel, große Dateien, gesetzte Geheimnisse.
- Migrationen nur additiv, mit einem Test, der zerstörerisches SQL im Quelltext findet.
- Datenänderungen nur mit Sicherung, Probelauf und menschlichem „ja“.
- Tests für jede neue Logik in Rechten und beim Zugriff über IDs.
- Dynamischer Scan nur gegen eine Wegwerf-Instanz in einem internen Netz.
- Prüfwerkzeuge nie aus dem geprüften Code laden, Versionen fest pinnen, CI-Runner ohne Root.
Vibe Coding macht mich deutlich schneller. Es verschiebt meine Arbeit vom Schreiben zum Prüfen, und die Pipeline ist der Teil des Prüfens, der nicht müde wird. Dass ich beim Aufschreiben selbst noch eine Root-Lücke in meiner eigenen Pipeline gefunden habe, ist dabei vielleicht die ehrlichste Lektion: Auch das Sicherheitsnetz braucht einen zweiten Blick.
Weiterlesen: Prompt Injection: Was KMU aus 460.000 Angriffen lernen können · Wenn der Angreifer ein LLM ist · Warum du fremde JavaScript-Bibliotheken nie ungeprüft laden darfst · Die Ignoranz-Falle · Schema.org per KI