Ich habe Apache NiFi vor fünf Jahren in den Technologiekatalog unserer Organisation aufnehmen lassen und setze es seit zwei Jahren selbst ein. Der Einstieg war mühsam, danach wurde NiFi für mich eines der besten Werkzeuge für selbst betriebene Datenflüsse. In diesem Artikel ziehe ich Bilanz und beschreibe das Zielbild für den Onlineshop von Affenhand: Produktfeeds, Warenwirtschaftsdaten und Lieferantenbestellungen sollen dort künftig in einem gemeinsamen Datenfluss laufen.
In vielen Organisationen wandern Daten zwischen Systemen hin und her, und jedes Team löst das auf seine Weise: mit einem Cron-Skript, einem Export per Hand oder einem Plugin, das irgendwer irgendwann installiert hat. Vor fünf Jahren habe ich deshalb Apache NiFi in unseren organisationsweiten Technologiekatalog aufnehmen lassen, als Empfehlung für genau diese Aufgabe. Apache Camel steht dort ebenfalls als Empfehlung.
Die beiden ergänzen sich gut. Camel ist ein Integrations-Framework, das man in eigenen Anwendungscode einbaut. NiFi ist ein eigenständiger Dienst, in dem Datenflüsse laufen, die man im Betrieb sehen, anhalten und nachverfolgen kann. Wer eine Schnittstelle programmiert, greift zu Camel. Wer Daten regelmäßig von A nach B bringen und dabei prüfen und umformen muss, ist bei NiFi richtig.
Das war, bevor n8n zum Gesprächsthema wurde. Heute liegt die Frage nahe, warum nicht einfach n8n. Meine Antwort hat zwei Teile. NiFi steht unter der Apache-Lizenz 2.0 und ist damit echte Open Source. Die Lizenz von n8n erlaubt den Eigenbetrieb, schränkt die Nutzung aber ein und ist keine anerkannte Open-Source-Lizenz. Für einen Katalog, auf den sich eine ganze Organisation verlassen soll, ist das ein Unterschied. Der zweite Teil ist die Bauart. n8n ist stark, wenn es darum geht, Dienste über ihre Schnittstellen zu verknüpfen. NiFi ist dafür gebaut, Daten zuverlässig zu bewegen, auch große Mengen, und dabei jeden Schritt aufzuzeichnen.
Der Einstieg war hakelig
Das will ich nicht schönreden. Der Anfang mit NiFi war zäh, und das lag nicht an der Software. Man muss erst in die Denkweise von NiFi hineinfinden.
Wer aus der Skriptwelt kommt, denkt in Schleifen und Variablen. Man liest eine Datei, geht Zeile für Zeile durch und schreibt das Ergebnis weg. In NiFi gibt es diese eine Schleife nicht. Es gibt Prozessoren, die jeweils eine Sache tun, und Warteschlangen, die sie verbinden. Durch diese Warteschlangen wandern sogenannte FlowFiles. Jedes FlowFile besteht aus einem Inhalt und aus Attributen. Der Inhalt ist das, was verarbeitet wird, also etwa eine JSON-Antwort oder eine CSV-Datei. Die Attribute sind Metadaten wie Dateiname, Seitenzahl oder Sprache. Bis man ein Gefühl dafür hat, was in den Inhalt gehört und was in ein Attribut, baut man Flows, die umständlich sind.
Die zweite Hürde ist der Umgang mit Fehlern. In einem Skript bricht man bei einem Fehler ab oder fängt ihn irgendwo ab. In NiFi hat jeder Prozessor eigene Ausgänge für Erfolg, Fehler und Wiederholung, und jeder dieser Ausgänge muss irgendwohin führen. Das wirkt am Anfang pedantisch. Inzwischen will ich es nicht mehr missen, weil kein Fehler mehr still verschwindet.
Ist diese Hürde genommen, zeigt NiFi seine Stärken. Die wichtigste ist für mich die Provenance. NiFi speichert für jedes FlowFile, woher es kam, welcher Prozessor es wann verändert hat und wie der Inhalt vorher und nachher aussah. Wenn am Ende einer Kette ein falscher Wert steht, lässt er sich Schritt für Schritt bis zur Quelle zurückverfolgen. Dazu kommt Backpressure: Läuft eine Warteschlange voll, bremst NiFi die vorderen Prozessoren, und der Speicher bleibt ruhig.
Ausgangslage bei Affenhand
Affenhand verkauft Ausstattung für Gyms und Heimtraining. Der Shop läuft auf WooCommerce mit WPML und hat drei Sprachen auf eigenen Domains: affenhand.de, affenhand.com und affenhand.fr. Davor sitzt Varnish als Cache, dahinter Redis als Objekt-Cache. Ich betreue die Technik.
Drei Datenbestände bestimmen das Geschäft. Der erste sind die Produktdaten im Shop selbst, also Titel, Preise, Bilder und Lagerstatus. Der zweite sind die Warenwirtschaftsdaten: Einkaufspreise, Lieferanten und Lieferanten-Artikelnummern. Sie liegen heute im Lager-Plugin ATUM, in einer eigenen Tabelle neben WooCommerce. Der dritte sind die Daten der Lieferanten, also deren Preise, Bestände und Lieferzeiten.
Google Shopping und mehrere Partnerportale lesen Preise, Verfügbarkeit und Bilder aus Produktfeeds. Diese Feeds erzeugt heute das Plugin CTX Feed innerhalb von WordPress. Es kennt nur den ersten der drei Datenbestände. Ob ein Produkt nachbestellt werden kann oder ob ein Aktionspreis unter dem Einkaufspreis liegt, weiß der Feed nicht.
Dazu kommen zwei technische Gründe. Im Redis des Shops tauchen regelmäßig Leerungen ganzer Cache-Gruppen auf. Sie laufen als Lua-Skript, dauern jeweils 1,0 bis 1,8 Sekunden und kommen oft paarweise. Solange so ein Skript läuft, wartet jede andere Anfrage an Redis. Ich habe den Verdacht, dass CTX Feed diese Leerungen nach seinen Läufen auslöst. Belegt ist das noch nicht. Und Ende Oktober stand im Fehlerlog des Shops immer wieder eine PHP-Warnung aus dem WordPress-Kern. Die Ursache war eine Feed-Konfiguration mit vier leeren Zeilen. Es hat eine Weile gedauert, bis die Spur beim Feed ankam. Wie wichtig saubere Logs dafür sind, habe ich in Die Ignoranz-Falle beschrieben.
Das Zielbild
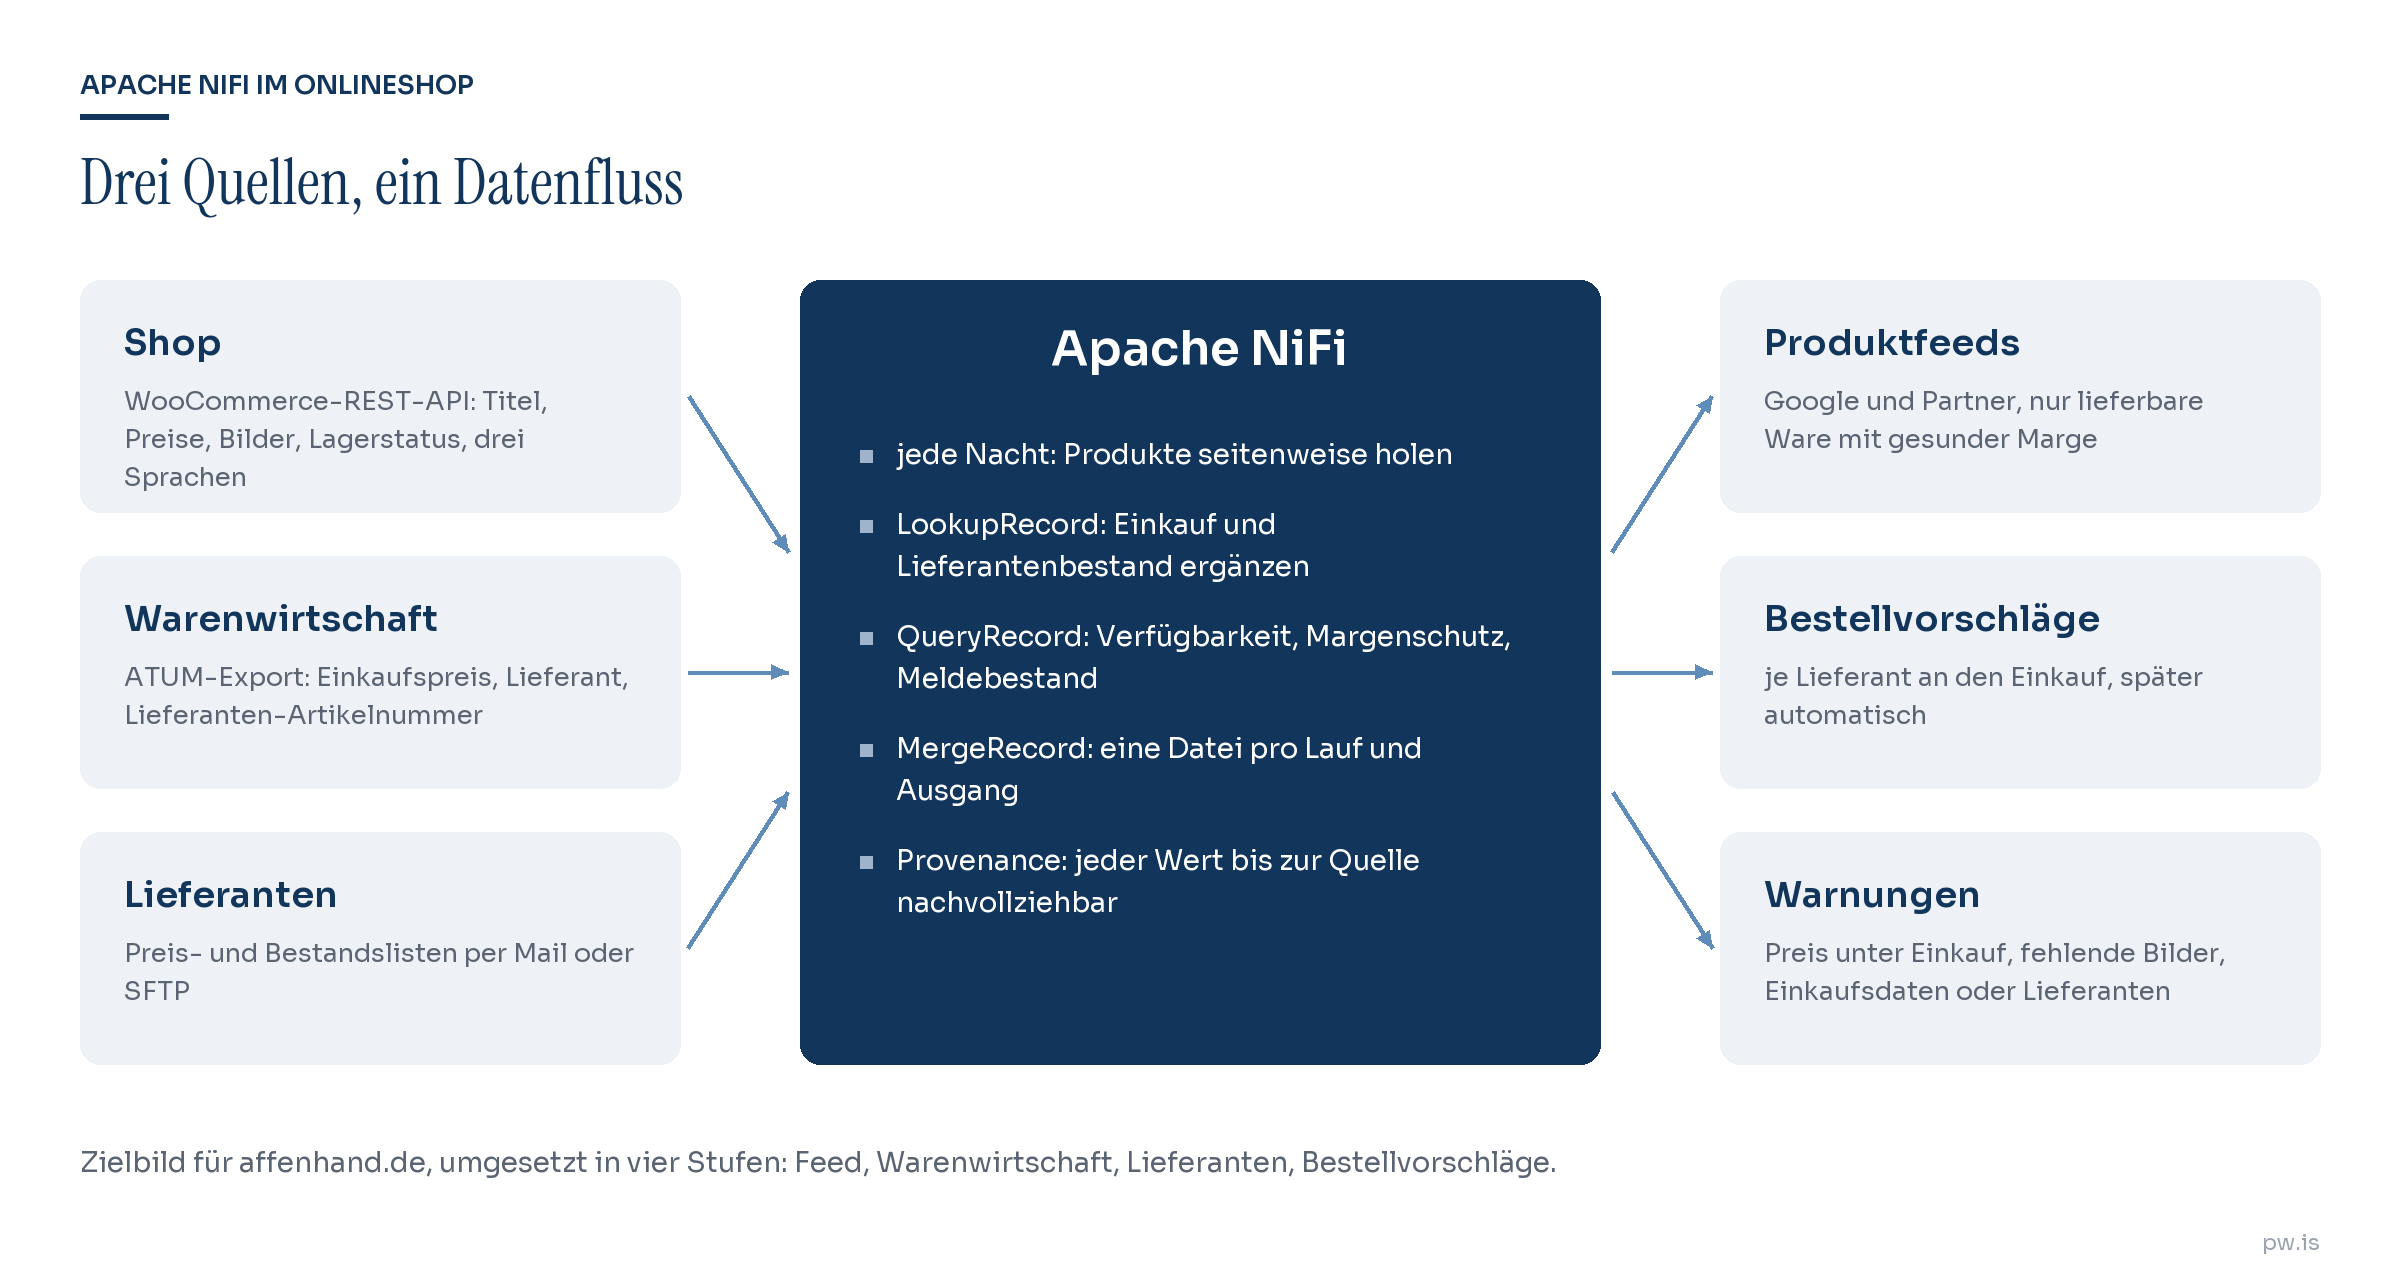
NiFi soll die drei Datenbestände zusammenführen. Daraus entstehen drei Ergebnisse.
Die Produktfeeds werden gegen die Warenwirtschaft geprüft. Ein Produkt, das der Shop als lieferbar führt, das aber weder auf Lager noch beim Lieferanten verfügbar ist, steht im Feed nicht als lieferbar. Ein Preis unter dem Einkaufspreis geht gar nicht erst in den Feed, sondern als Warnung an das Shop-Team. So wirbt der Shop nicht mit Ware, die er nicht liefern kann, und nicht mit Preisen, bei denen er draufzahlt.
Die Bestellvorschläge entstehen aus demselben Lauf. Unterschreitet ein Artikel seinen Meldebestand, landet er auf einer Liste, getrennt nach Lieferant und mit dessen Artikelnummer. Diese Liste geht zuerst an den Einkauf, der sie freigibt. Für Lieferanten mit verlässlichen Daten soll die Bestellung später automatisch rausgehen.
Und alles, was nicht passt, wird sichtbar. Produkte ohne Bild, ohne Einkaufspreis oder ohne Lieferant landen in eigenen Listen, statt einfach aus dem Feed zu verschwinden.
Die Umsetzung erfolgt in vier Stufen, jede baut auf der vorigen auf: zuerst der Feed aus den Shop-Daten, dann der Abgleich mit der Warenwirtschaft, dann die Bestandslisten der Lieferanten und zuletzt die Bestellvorschläge.
Betrieb: ein eigener Server und ein Tunnel
NiFi soll nicht auf dem Shop-Server laufen. Es ist eine Java-Anwendung, will 2 bis 4 GB Arbeitsspeicher und braucht Platz auf der Platte für seine Repositories. Auf dem Shop-Server gehört der Speicher Varnish, Redis und MariaDB. NiFi bekommt deshalb einen kleinen eigenen Server. Mit dem Shop spricht es über die WooCommerce-REST-API, per HTTPS und mit einem API-Schlüssel, der ausschließlich lesen darf.
Der Container hat eine festgelegte Version, und die Oberfläche ist nur von localhost aus erreichbar:
services:
  nifi:
    image: apache/nifi:${NIFI_VERSION}
    container_name: affenhand-nifi
    restart: unless-stopped
    ports:
      - "127.0.0.1:8443:8443"
    environment:
      NIFI_WEB_HTTPS_PORT: "8443"
      NIFI_WEB_PROXY_HOST: "localhost:8443"
      NIFI_JVM_HEAP_INIT: "2g"
      NIFI_JVM_HEAP_MAX: "2g"
      SINGLE_USER_CREDENTIALS_USERNAME: ${NIFI_USER}
      SINGLE_USER_CREDENTIALS_PASSWORD: ${NIFI_PASSWORD}
    volumes:
      - nifi-conf:/opt/nifi/nifi-current/conf
      - nifi-state:/opt/nifi/nifi-current/state
      - nifi-database:/opt/nifi/nifi-current/database_repository
      - nifi-flowfile:/opt/nifi/nifi-current/flowfile_repository
      - nifi-content:/opt/nifi/nifi-current/content_repository
      - nifi-provenance:/opt/nifi/nifi-current/provenance_repository
      - /opt/affenhand-nifi/daten:/opt/affenhand-nifi/daten
      - /opt/affenhand-nifi/feeds:/opt/affenhand-nifi/feeds

volumes:
  nifi-conf:
  nifi-state:
  nifi-database:
  nifi-flowfile:
  nifi-content:
  nifi-provenance:
Version und Zugangsdaten stehen in einer .env-Datei neben der Compose-Datei und nicht im Repository. NiFi verlangt ein Passwort mit mindestens zwölf Zeichen. Die Konfiguration liegt in einem benannten Volume, weil Docker ein solches Volume beim ersten Start mit dem Inhalt aus dem Image füllt. Ein leeres Bind-Mount würde den Ordner dagegen überdecken, und NiFi fände seine Konfiguration nicht.
Docker legt benannte Volumes normalerweise unter /var/lib/docker ab. Auf unseren Servern gehören eigene Daten nach /opt, deshalb bekommt Docker dort sein Datenverzeichnis:
{ "data-root": "/opt/docker" }Die Ordner daten und feeds müssen dem Benutzer gehören, unter dem NiFi im Container läuft. Das ist die UID 1000. Auf die Oberfläche kommt man nur über einen SSH-Tunnel:
ssh -L 8443:127.0.0.1:8443 nifi-host
# danach im Browser: https://localhost:8443/nifi
Den API-Schlüssel des Shops speichert NiFi in einem Parameter-Kontext, das Secret als sensiblen Parameter. NiFi zeigt sensible Werte in der Oberfläche nicht mehr an und nimmt sie auch nicht in exportierte Flow-Definitionen auf.
Stufe 1: Produktdaten aus dem Shop holen
GenerateFlowFile startet jede Nacht einen Lauf pro Sprache. Der Prozessor ist auf die Zeitplanung CRON driven eingestellt, zum Beispiel mit 0 30 2 * * ? für 2:30 Uhr. Eigene Eigenschaften des Prozessors werden zu Attributen des FlowFiles:
page    = 1
sprache = de
lauf    = ${now():format('yyyyMMdd-HHmmss')}
Danach ruft InvokeHTTP die WooCommerce-REST-API auf. Zuerst holt der Flow nur einfache Produkte, die Varianten folgen in einem zweiten Abruf.
HTTP URL:          #{wc_basis_url}/wp-json/wc/v3/products?status=publish&type=simple&per_page=100&page=${page}&lang=${sprache}
Request Username:  #{wc_key}
Request Password:  #{wc_secret}
Response Header Request Attributes Enabled: true
Den Parameter lang stellt WPML bereit. Mit ihm liefert die API die Produkte in der gewünschten Sprache, und die Links zeigen auf die passende Länderdomain.
Wie viele Seiten es gibt, schreibt WooCommerce in den Antwort-Header X-WP-TotalPages. Die letzte Einstellung oben sorgt dafür, dass dieser Wert auch am ursprünglichen FlowFile hängt, das InvokeHTTP über den Ausgang Original weiterreicht. An diesem FlowFile setzt eine Schleife an. Ein UpdateAttribute erhöht die Seitenzahl:
page = ${page:toNumber():plus(1)}Ein RouteOnAttribute prüft dann, ob noch eine Seite fehlt:
weiter = ${page:toNumber():le(${'X-WP-TotalPages':toNumber()})}Der Ausgang weiter führt zurück zu InvokeHTTP, alle anderen FlowFiles verlassen die Schleife. Der Name des Headers steht in Anführungszeichen, weil er Bindestriche enthält. InvokeHTTP arbeitet mit nur einem Task gleichzeitig. Jede Seite ist für den Shop eine Anfrage, die am Cache vorbei bei PHP landet, und diese Anfragen sollen nachts nacheinander kommen.
An die Antwort jeder Seite hängt ein weiteres UpdateAttribute drei Werte, die später beim Zusammenführen gebraucht werden:
fragment.identifier = ${lauf}-${sprache}
fragment.index      = ${page}
fragment.count      = ${'X-WP-TotalPages'}
Die API liefert pro Seite ein JSON-Array mit verschachtelten Produkten. Eine Jolt-Transformation vom Typ shift übernimmt nur die Felder, die weiter gebraucht werden. Die Adresse des ersten Bildes holt sie dabei aus der Bildliste nach oben:
[{
  "operation": "shift",
  "spec": {
    "*": {
      "id": "[&1].id",
      "sku": "[&1].sku",
      "name": "[&1].title",
      "short_description": "[&1].description",
      "permalink": "[&1].link",
      "images": { "0": { "src": "[&3].image_link" } },
      "regular_price": "[&1].regular_price",
      "sale_price": "[&1].sale_price",
      "stock_status": "[&1].stock_status",
      "stock_quantity": "[&1].stock_quantity",
      "low_stock_amount": "[&1].low_stock_amount"
    }
  }
}]
Die Kurzbeschreibung enthält HTML. Ein UpdateRecord mit der Strategie Record Path Value entfernt die Tags:
/description = replaceRegex(/description, '<[^>]*>', '')Stufe 2: Abgleich mit der Warenwirtschaft
Einkaufspreis und Lieferant stehen in der ATUM-Tabelle, und die liefert die normale WooCommerce-REST-API nicht aus. Deshalb schreibt ein nächtlicher Export auf dem Shop-Server diese Daten als Tabelle mit Tabulatoren in ein Verzeichnis, das NiFi per SFTP abholt. Lesend, mit einem eigenen Konto, das nur dieses Verzeichnis sieht:
wp db query "
  SELECT pm.meta_value AS sku, a.purchase_price, a.supplier_id, a.supplier_sku
  FROM wp_atum_product_data a
  JOIN wp_postmeta pm ON pm.post_id = a.product_id AND pm.meta_key = '_sku'
  WHERE pm.meta_value <> ''
" > /opt/affenhand-export/einkauf.tsv
In NiFi holen ListSFTP und FetchSFTP die Datei ab und legen sie unter /opt/affenhand-nifi/daten/einkauf.tsv ab. Auf diese Datei zeigt ein CSVRecordLookupService mit sku als Schlüsselspalte. Der Dienst lädt die Datei neu, sobald sie sich ändert.
Ein LookupRecord im Produktfluss fragt diesen Dienst für jeden Datensatz ab:
Lookup Service:          einkauf-lookup
key:                     /sku
Result RecordPath:       /
Record Result Contents:  Insert Record Fields
Routing Strategy:        Route to 'matched' or 'unmatched'
Damit stehen purchase_price, supplier_id und supplier_sku direkt neben den Shop-Feldern. Produkte ohne Eintrag in der Warenwirtschaft gehen über den Ausgang unmatched in eine eigene Liste. Das sind genau die Artikel, bei denen im Einkauf etwas fehlt.
Stufe 3: Bestände der Lieferanten
Lieferanten schicken ihre Preis- und Bestandslisten in sehr unterschiedlicher Form, als CSV per Mail, als Datei auf einem SFTP-Server oder als Excel-Export. NiFi holt sie mit ConsumeIMAP oder ListSFTP ab. Jeder Lieferant bekommt einen eigenen ConvertRecord mit einem Reader, der sein Format kennt, und ein UpdateRecord, das die Spalten auf ein gemeinsames Schema bringt: supplier_sku, lieferant_bestand, lieferzeit_tage.
Ein MergeRecord fasst die Listen aller Lieferanten zusammen, PutFile schreibt sie nach /opt/affenhand-nifi/daten/lieferanten.tsv. Ein zweiter CSVRecordLookupService mit supplier_sku als Schlüssel und ein zweiter LookupRecord im Produktfluss ergänzen damit jeden Datensatz um den Bestand beim Lieferanten.
Feed, Warnungen und Bestellvorschläge aus einem Lauf
QueryRecord wendet SQL auf die angereicherten Datensätze an. Jede eigene Eigenschaft des Prozessors enthält eine Abfrage und bildet zugleich einen eigenen Ausgang. Aus einem einzigen Lauf entstehen so mehrere Ergebnisse.
Die Eigenschaft feed baut den Produktfeed und prüft dabei Verfügbarkeit und Marge:
SELECT
  id,
  title,
  description,
  link,
  image_link,
  CASE
    WHEN stock_status = 'instock'                       THEN 'in_stock'
    WHEN CAST(lieferant_bestand AS INTEGER) > 0         THEN 'backorder'
    ELSE 'out_of_stock'
  END AS availability,
  regular_price || ' EUR' AS price,
  CASE WHEN sale_price <> '' THEN sale_price || ' EUR' ELSE '' END AS sale_price,
  sku AS mpn,
  'new' AS "condition"
FROM FLOWFILE
WHERE title <> ''
  AND image_link IS NOT NULL
  AND regular_price <> ''
  AND CAST(COALESCE(NULLIF(sale_price, ''), regular_price) AS DOUBLE) / 1.19
      > CAST(purchase_price AS DOUBLE)
Die letzte Bedingung ist der Margenschutz. Shoppreis und Einkaufspreis müssen dafür auf dieselbe Basis gebracht werden, also beide netto. Im Beispiel steht der Faktor 1,19 für den deutschen Steuersatz. Für die anderen Länder bekommt jeder Lauf seinen eigenen Faktor als Attribut.
Die Eigenschaft unter_einkaufspreis enthält die umgekehrte Bedingung. Ihr Ausgang geht per PutEmail an das Shop-Team, mit Artikelnummer, Verkaufspreis und Einkaufspreis. Ein falsch eingetragener Aktionspreis fällt so am nächsten Morgen auf und nicht erst in der Monatsauswertung.
Die Eigenschaft nachbestellen sammelt alles, was unter den Meldebestand gefallen ist:
SELECT supplier_id, supplier_sku, sku, title, stock_quantity, low_stock_amount
FROM FLOWFILE
WHERE stock_quantity IS NOT NULL
  AND low_stock_amount IS NOT NULL
  AND CAST(stock_quantity AS INTEGER) <= CAST(low_stock_amount AS INTEGER)
Den Meldebestand pflegt der Shop pro Produkt im WooCommerce-Feld für niedrigen Lagerbestand. Wo er fehlt, taucht das Produkt nicht auf. Auch das ist eine Liste wert.
Eine Kleinigkeit kann einen Lauf blockieren: QueryRecord gibt auch für eine Seite ohne passenden Datensatz ein leeres FlowFile aus. Diese Einstellung muss so bleiben. Fehlt beim Zusammenführen ein Teil, wartet der nächste Schritt vergeblich auf ihn.
Zusammenführen und ausliefern
MergeRecord arbeitet mit der Strategie Defragment. Der Prozessor wartet, bis von einem fragment.identifier so viele Teile angekommen sind, wie fragment.count angibt, und schreibt sie dann als eine Datei. Für den Feed dient als Writer ein CSVRecordSetWriter mit Tabulator als Trennzeichen und einer Kopfzeile. Das ergibt das TSV-Format, das das Merchant Center einliest. Eine maximale Wartezeit von 30 Minuten sorgt dafür, dass ein unvollständiger Lauf nicht ewig in der Warteschlange liegt. Er landet dann im Fehlerweg.
Ein UpdateAttribute setzt den Dateinamen google-${sprache}.tsv, und PutFile schreibt die Datei nach /opt/affenhand-nifi/feeds/. PutFile schreibt zuerst in eine versteckte Datei und benennt sie erst am Ende um. Wer den Feed in diesem Moment abholt, bekommt deshalb nie eine halbe Datei.
Die Bestellvorschläge laufen nach dem Zusammenführen durch ein PartitionRecord mit /supplier_id als Schlüssel. Daraus entsteht eine Datei pro Lieferant, die PutEmail als Anhang an den Einkauf schickt. Nach der Freigabe bestellt der Einkauf. Bei Lieferanten mit stabilen Daten und einem eigenen Bestellweg schickt NiFi in der letzten Ausbaustufe die Bestellung direkt, per Mail oder über die Schnittstelle des Lieferanten.
Absehbare Stolpersteine
Die Produkt-IDs müssen genau denen im bisherigen Feed entsprechen. Das Merchant Center verknüpft Historie und Leistungsdaten mit der ID. Wer beim Umstieg zum Beispiel von der Beitrags-ID auf die Artikelnummer wechselt, fängt bei Google wieder bei null an. Welche ID CTX Feed heute ausgibt, steht in seiner Feed-Konfiguration, und genau diese übernimmt der neue Flow.
Marke und GTIN liegen in jedem Shop an einer anderen Stelle. CTX Feed holt sie über eigene Zuordnungen, und diese Zuordnungen wandern unverändert in die Jolt-Transformation.
Variable Produkte brauchen einen zweiten Abruf. Google erwartet jede Variante als eigenen Eintrag mit einer gemeinsamen item_group_id, und WooCommerce liefert Varianten nur über einen eigenen Endpunkt pro Produkt. Das bedeutet eine zweite Schleife im Flow. Bestand und Meldebestand hängen bei Varianten oft an der Variante und nicht am Hauptprodukt, das gilt auch für die Bestellvorschläge.
Für backorder verlangt Google zusätzlich ein Datum, ab dem die Ware lieferbar ist. Das lässt sich aus der Lieferzeit des Lieferanten berechnen, aber nur, wenn die Lieferzeit in seiner Liste verlässlich gepflegt ist.
Und die Lieferantenlisten selbst sind die größte Fehlerquelle. Ein Lieferant ändert eine Spaltenüberschrift, und sein ganzer Bestand steht plötzlich auf null. Deshalb prüft der Flow jede Lieferantenliste vor dem Zusammenführen. Fällt die Zahl der Artikel mit Bestand gegenüber dem Vortag um mehr als die Hälfte, geht die Liste in den Fehlerweg. Der alte Stand bleibt dann gültig.
Wann sich NiFi nicht lohnt
Für einen einzelnen Feed in einer Sprache ist NiFi zu groß. Ein WP-CLI-Befehl mit 60 Zeilen PHP, nachts per Cron gestartet, würde dasselbe leisten und bräuchte keinen eigenen Server.
NiFi lohnt sich, wenn mehrere Datenflüsse zusammenkommen. Bei Affenhand sind das drei Sprachen mal mehrere Kanäle, dazu Warenwirtschaft, Lieferanten und Einkauf. Später kann der monatliche DATEV-Export für die Buchhaltung dazukommen, der heute als eigenes Skript läuft. Alle diese Flüsse haben dann dieselbe Provenance, dieselben Fehlerwege und dieselbe Überwachung. Das ist derselbe Grund, aus dem ich NiFi vor fünf Jahren empfohlen habe.
Der Preis dafür ist ein weiteres System, das gepflegt werden muss. NiFi braucht regelmäßig Updates, Java ebenso. Die Oberfläche ist ein lohnendes Angriffsziel und hängt deshalb nur am Tunnel. Und weil ein Flow in der Oberfläche entsteht, fehlt ihm von Haus aus die Versionierung, die Code in Git hat. Die Prozessgruppe wird deshalb nach jeder Änderung als Flow-Definition im JSON-Format exportiert und ins Repository gelegt. Ein Diff darauf ist nicht schön zu lesen, zeigt aber, was sich geändert hat.
Am Ende entscheidet bei einem Onlineshop nicht die Technik, ob sich so ein Aufbau lohnt. Es entscheidet die Frage, wie oft ein Feed Ware bewirbt, die nicht lieferbar ist, oder einen Preis, bei dem der Shop draufzahlt. Wenn NiFi das jeden Morgen beantwortet, bevor ein Kunde es merkt, hat sich der zusätzliche Server bezahlt gemacht.
Weiterlesen: KI-Bots im Onlineshop: fast 1,8 Millionen Anfragen in einer Woche · Die fünf Kunden, die deine Marge auffressen · Die Ignoranz-Falle · Wie Du endlich richtige Logs erzeugst: NGINX Logs als JSON · Vibe Coding mit Sicherheitsnetz